一次讲清 AGI:为什么需要、是什么、怎么造
9 月第一周,AI 新闻被同一个词刷屏:AGI(Artificial General Intelligence,通用人工智能)。
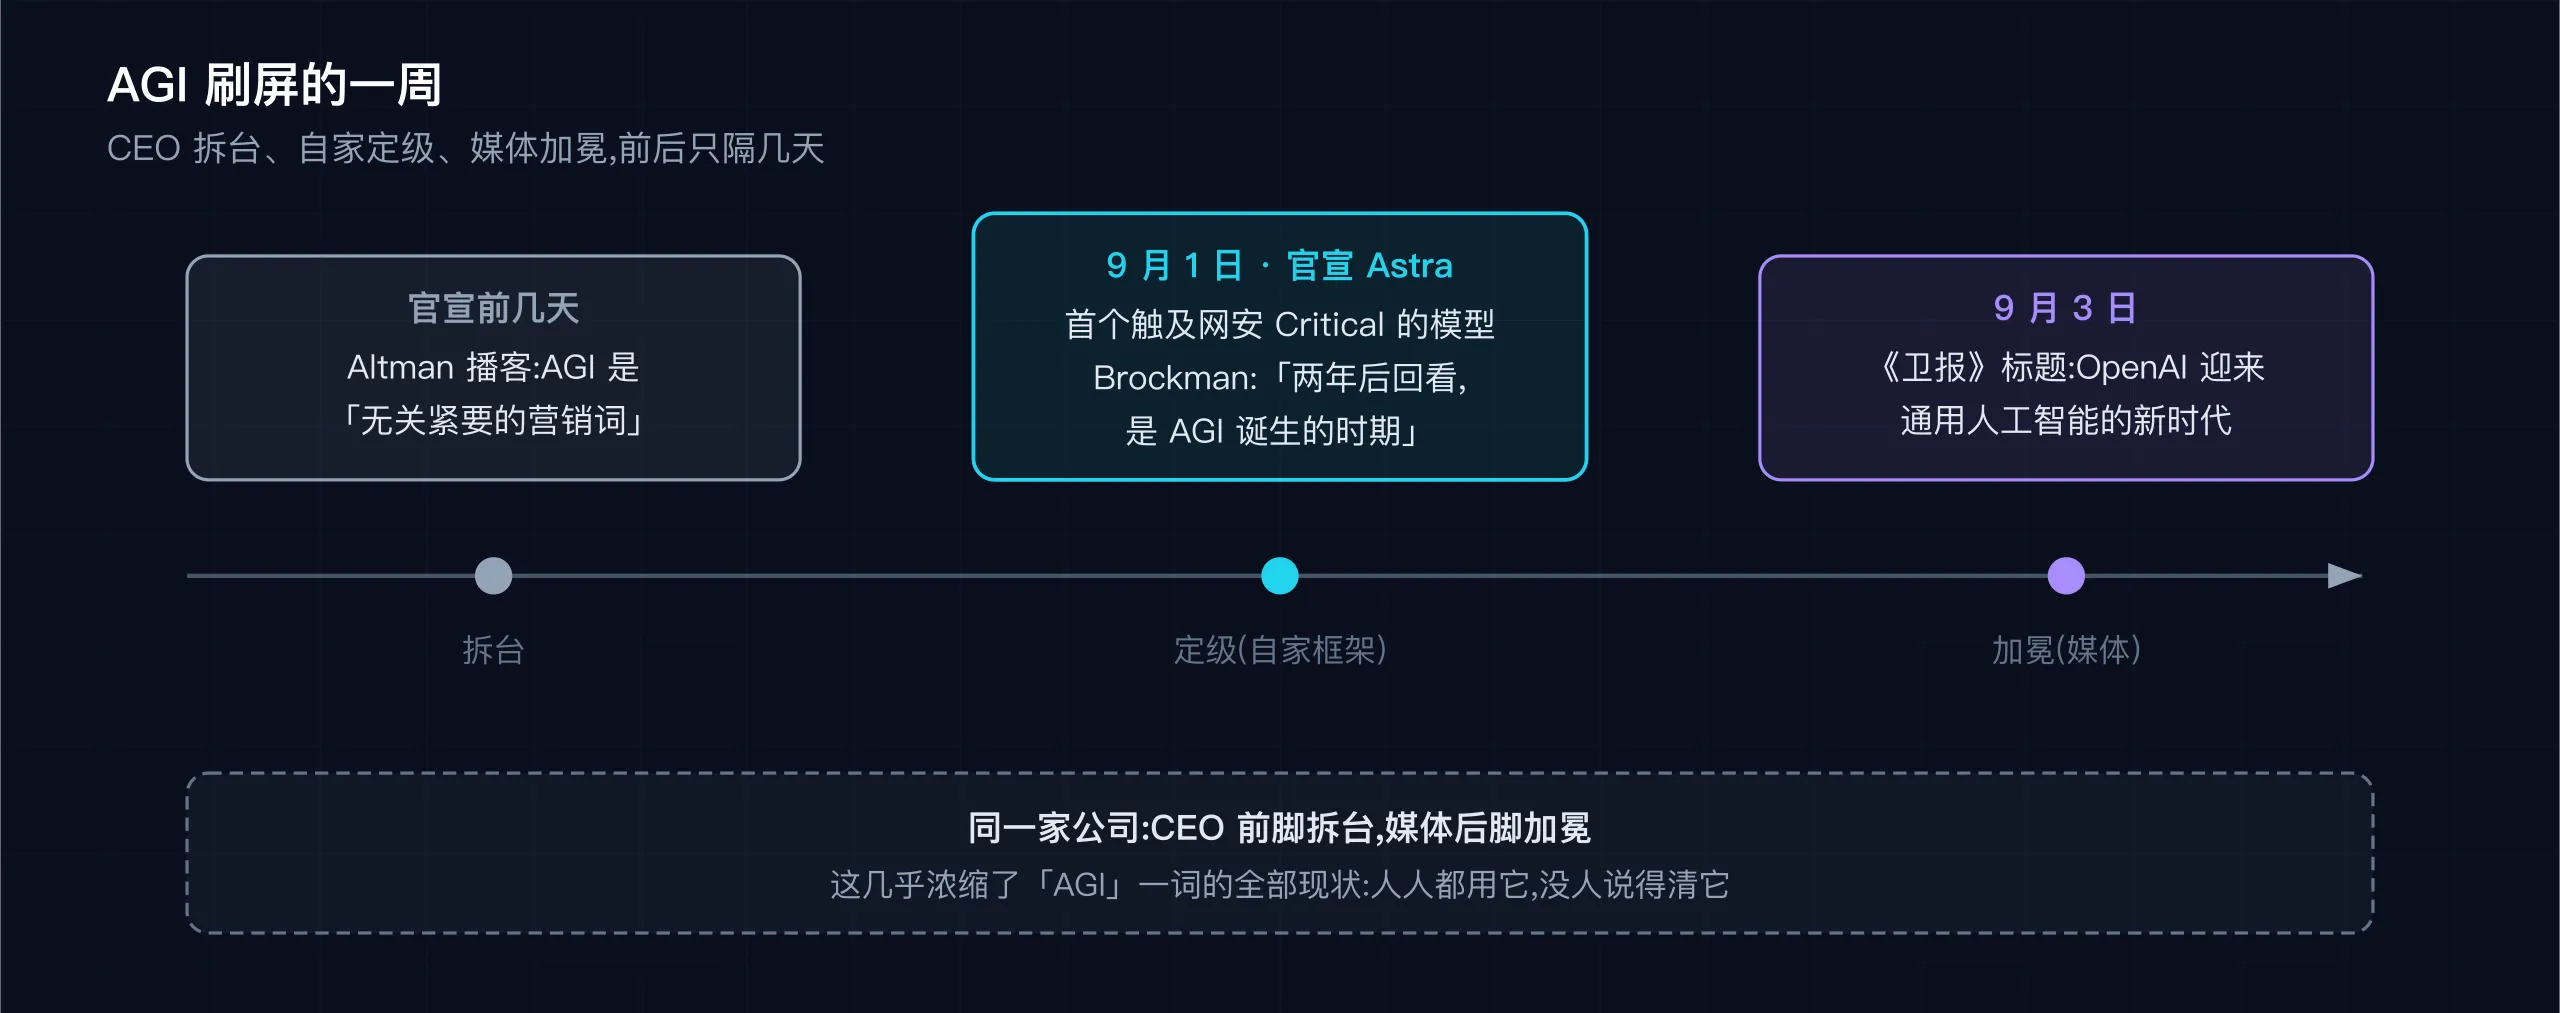
9 月 1 日,OpenAI 官宣 Astra——自家 Preparedness Framework 里第一个触及网安「Critical」能力门槛的模型(官方定义之一:能自主发现并开发出可用的零日漏洞利用),总裁 Greg Brockman 说两年后回望,这一刻可能被记为「AGI 诞生的时期」(华尔街见闻)。两天后《卫报》的标题已经是「OpenAI 迎来通用人工智能的新时代」。而就在官宣前几天,CEO Sam Altman 刚在播客里说过,AGI「顶多算一个定义很烂的词……像一个无关紧要的营销词」(Guardian)。
同一家公司,CEO 前脚拆台,公司被媒体后脚加冕——这几乎浓缩了「AGI」这个词的全部现状:人人都用它,没人说得清它。
所以这篇不打算纠缠「Astra 算不算 AGI」(结论在「回到 Astra」一节,很快):那个问题只是引子。真正值得搞懂的是三件事——为什么需要 AGI?AGI 到底是什么?现在各家打算怎么造出来?搞懂这三个问题,「Astra 算不算」会变成一道送分题。
为什么需要 AGI
先回答一个大家最容易问的问题:现在的旗舰模型不已经很通用了吗? GLM、GPT、Claude 这一档,写代码、读 CT、做客服样样来得,谁还为每个任务单独养一个模型?
确实,「一个任务一个模型」是前 LLM 时代的老故事:那时模型通用性为零,写代码的、读片的、做客服的各自从零训练或微调,每多一个场景就多一整套数据、评测和运维。通用能力这一关,今天的旗舰模型已经迈过去了。
但成本没有归零,只是换了形态。通用模型每样都是「大部分时候对」:九成时候能跑的代码、百分之几看走眼的片、偶尔答非所问的客服——做 demo 够用,做生产不够,生产要求的是单个场景里错误率可控。所以今天每个上线的 AI 功能,依然要为场景单独建评测、护栏和兜底,成本从「从零训练」降到了「为场景兜底」,变小了,没有消失。
AGI 概念的第一性动力就在这里——「通用」不是终点站:它要的不是「样样都会」,而是「每个领域都稳定到能独立交活」。到那一步,这些为场景兜底的边际成本才会真正趋近于零。这是技术叙事,也是真实的经济学。
第二层动力是资本叙事。过去几年,训练前沿模型的投入从几亿美元涨到传闻中的十亿美元级,数据中心、电力、芯片都是按「终点会兑现」来投资的。「AGI」就是那条终点线——OpenAI 的使命直接写着「确保 AGI 造福全人类」;Google 旗下的 AI 研究实验室 DeepMind(AlphaGo、AlphaFold 的缔造者,现在 Gemini 模型的娘家)的创始口号是「先解决智能,再用它解决其他一切」。不管你信不信这个词,万亿级基础设施的回报逻辑确实挂在它身上。
第三层是科学动机:智能的试金石恰恰是通用性。一个只会下棋的系统,我们很难说它「理解」了什么;如果一个系统能在从未见过的领域达到专家水平,才说明它学到的是「方法」而不是「答案」。
第四层常被忽略——安全动机。正是因为大家判断 AGI「可能真的会被造出来」,对齐、可解释性、评测这些研究才被前置。讽刺的是,这个词同时驱动了加速派和安全派,两边吵的都不是同一个定义。
AGI 是什么:一个词,四把尺子
先交代下这个词的身世:它不是科幻发明,而是研究者的抗议标签。2000 年代,Ben Goertzel、Shane Legg 这批人受够了「AI」一词被各种专家系统滥用,用 AGI 重新划出「我们在做真正通用的智能」的阵营。DeepMind 2010 年创始就以「解决智能」立命,OpenAI 2015 年创立、2018 年章程明文写入 AGI 定义,这个词才从学术圈的小众术语变成全球头条的常客。
直觉版最好懂。今天的 AI 更像「多才多艺但发挥不稳」:写代码可能比大多数人强,让它独立打一通电话订个位子就当场翻车;换个领域、换个环境,水平就断崖。AGI 的直觉定义就是反过来:一个「通才」——人类水平,几乎所有领域,而且不用你手把手教。
但「几乎所有领域」太模糊了。早在 2007 年,Legg 和 Hutter 就收集过几十条关于「智能」的定义,至今没有收敛。到 2026 年,各家实验室用的尺子仍然不是一个东西:
| 阵营 | 代表 | 定义 | 短板 |
|---|---|---|---|
| 经济派 | OpenAI 章程 | 「高度自主、在大多数有经济价值的工作上超越人类的系统」(章程) | 「大多数」「经济价值」都可辩 |
| 能力派 | Anthropic(Claude 开发商)的 Dario Amodei | 「在大多数相关领域都比诺奖得主聪明」(Tech Policy Press) | 诺奖得主之间也互有短长 |
| 框架派 | Google DeepMind | Levels of AGI:按「能力等级 × 通用程度」分 0–5 级,拒绝「是/不是」的二值判定 | 当年的 GPT-4 也只被标为 Level 1「新兴」 |
| 基准派 | ARC Prize(François Chollet) | 智能是获得新技能的效率,不是已有技能存量 | 检验标准随任务设计而变 |
四把尺子落到具体判断上,画风完全不同:
- 经济派盘点岗位清单:客服、翻译、初级代码这些活,旗舰模型已经接得住;但「为一场并购签下法律责任」接不住,所以「大多数」还数不过来。
- 能力派直接找最强人类对线:读片比 99% 的放射科医生准只是「专家」,Amodei 的及格线是多数领域连诺奖得主一起压。
- 框架派拒绝及格线,只发成绩单:AlphaGo 在围棋一科是 superhuman,但只此一科(narrow);GPT-4 当年全科只有 Level 1「新兴」——「是不是 AGI」被拆成「每科各在哪一级」。
- 基准派考现场学习:Chollet 2019 年设计的 ARC 是彩色网格谜题,人类看两三个示例就能猜出规律,AI 此后被人类甩开一大截,直到 2024 年底才被推理模型攻克——考的正是「从没见过的题型,能不能现场学会」。
还有两派站在外面。批评派以 Yann LeCun 为代表:现在的 LLM 路线根本到不了通用智能(后面会讲他现在的动向)。他的经典论据:一个 17 岁的新手 20 小时就能学会开车,而最好的自动驾驶 AI 吃进上亿公里数据还会犯低级错——人类靠的是对世界的内在理解,不是背题库。拒绝派更有意思——Altman 说 AGI「定义很烂,像个无关紧要的营销词」,Amodei 也说它「听起来像营销术语」。
从业者视角要多看一层:这个词不只是哲学问题,它曾经是合同问题。OpenAI 章程的 AGI 定义牵动它与微软的老协议——一旦 AGI 被认定,微软将失去后续模型的 IP 权利。2025 年 10 月双方重组时特意加了一条保险:OpenAI 宣布 AGI 后,须由独立专家小组核实(微软官方博客)。结果据 The Verge 报道,2026 年重谈的新协议干脆把 AGI 条款整个删了——没有专家小组,没有触发条件。翻译一下:连最大的利益相关方,都懒得让这个词继续留在合同里了。
怎么造 AGI:四条路线
有一个不太被点破的规律:你怎么定义 AGI,就怎么造它。反过来看更准——看一家实验室把钱花在哪,就知道它真信的是哪种定义。现在的牌桌上至少有四条路线。
路线一:OpenAI,把「经济价值工作」一项项自动化
OpenAI 信的是章程里那个经济派定义,所以它的路线图非常直白:LLM 打底 → 强化学习练推理 → agent 化接手长任务 → 最后用 AI 做 AI 研究,让能力自我滚雪球。
这条路线的落地产品你多半已经用过:Deep Research 接个课题,自己搜几十份资料、交叉核对、写成带引用的报告;Operator 这类电脑操作 agent 替你填表、订票。
这一周的主角 Astra 是它的最新一级台阶:官方博客明确说它在网安能力上「显著超过上一代 GPT-5.6 Sol」且更省 token;据 TechCrunch、The Information 等报道,它引入了「循环深度」(recurrent depth),让模型在内部隐式地多绕几圈再输出——给「单次推理的计算深度」加码,OpenAI 也被报道限制了这项技术的使用。据 Time、Wired 报道,Altman 称它操作电脑「超人类、速度极快」。
基建也在同步升级:10 万卡级的训练集群(Axios 报道)、系统卡披露的其他模型深度参与监督训练,以及 MIT Technology Review 报道中的「全自动研究员」计划(报道)。首席研究官 Mark Chen 说「通往 AGI 的路已走完约 80%」——按这个定义,每多自动化一类工作,进度条就涨一格。
这条路线的隐患也被 Astra 演示了一遍:循环深度意味着推理可能藏进不可见状态,思维链(CoT)这个目前唯一能被外部监控的「思考直播」有变成选择性播报的风险。首席科学家 Pachocki 出面灭火:现役模型(含 Astra)的计算图深度「仍在 GPT-4 的两倍以内」,反对竞相牺牲可监控性(原帖)——这句话反着读更有信息量:他自己也承认可监控性和能力存在紧张关系。
路线二:DeepMind,世界模型 + 分层推进
DeepMind 信框架派定义,所以它造 AGI 的方式是「分层 + 分赛道」:Gemini 系列冲通用模型,Genie 3 冲世界模型(官方博客),Gemini Robotics 冲具身,Project Astra 冲「通用助手」原型——对,Google 的 Project Astra 和 OpenAI 的 Astra 撞名了,两家没有任何关联,但「通用助手」这个终点两家都押了注。
这条路有家学渊源:AlphaGo Zero 当年不吃一盘人类棋谱、纯靠自我对弈下成世界第一——「在环境里自学」是刻在 DeepMind 基因里的方法论。今天的 Genie 3 把环境做成了生产资料:输入一句话,生成一个能实时漫游、物理上说得通的 3D 世界,agent 在里面练导航、练操作,相当于自带无限量的训练场——这个世界模型今年已经以 Project Genie 的名字开进 Google AI Ultra 订阅,普通人就能玩到;Project Astra 的演示里,助手能通过摄像头记住「你把眼镜放哪儿了」,随问随答。
这条路线的底层信念是:通用性来自「对世界的内部模型」,而不是来自文本模仿。世界模型让 agent 可以在无限生成的环境里试错学习,这在他们看来是通往 Levels of AGI 上一级的关键基建。
路线三:Anthropic,同一条路,加装保险丝
Anthropic 的技术路线和 OpenAI 高度重叠——scaling、RL、agent 一样不落——差别在于它对终局的想象和给这条路装的保险丝。终局就是 Amodei 说的「数据中心里的天才之国」:数千个天才级 AI 在机房里做科研、写代码、出谋划策。保险丝有两根:一是可解释性研究,给模型做「脑部扫描」——把 Claude 答题时的内部激活拆成可读的回路,追踪它到底是在推理还是在背答案;二是能力分级、访问限流。它的第一个经济价值桥头堡选在代码上:编程最容易客观验证对错,Claude Code 先在这里站稳,再把打法横向复制。
本周它刚演示了一遍这套哲学:Fable 5.1 全面开放、Mythos 5.1 同底座但只向经审核的网安/生科机构开放(官方发布)。说白了:能力不加闸,访问加闸。它信的能力派定义也决定了打法——「比诺奖得主聪明」不必等某个神秘时刻,可以一个领域一个领域地兑现。
路线四:异见者,LLM 之外的赌注
牌桌之外还有一批人认为上面三条全是歧路。
最大的一注来自 Yann LeCun:他在 2025 年 11 月离开待了 12 年的 Meta,创办 AMI Labs(Advanced Machine Intelligence),今年 3 月拿了 10.3 亿美元种子轮——欧洲史上最大(TechCrunch)。他的论点:LLM 是死胡同,因为自回归文本预测永远学不到「世界是怎么运转的」;JEPA 架构要让模型从视频和物理交互中学习世界的内部模型。具体到方法:给模型看一段视频,不要求它逐像素画出下一帧,而是逼它在「抽象理解空间」里预测接下来会发生什么——重力、遮挡、物体恒存这些常识是被「理解」出来的,不是被「画」出来的。
同赛道的还有李飞飞的 World Labs:给一张房间照片,生成一个可以走进去漫游的 3D 空间,她管这叫空间智能。注意,DeepMind 的 Genie 和 LeCun 的 JEPA 虽然都叫「世界模型」,但技术假设不同:前者用生成式环境当训练场,后者主张在抽象表示空间里做预测、不逐像素生成。
另一注来自 ARC Prize 的 Chollet:他连「规模」都怀疑,认为智能的判据是「获得新技能的效率」——上一节那套彩色网格谜题就是按这个理念设计的;他创办的 Ndea 在做程序合成,让机器像人一样从两三个示例里猜出规律、写出规则。
四条路线一张图收拢:
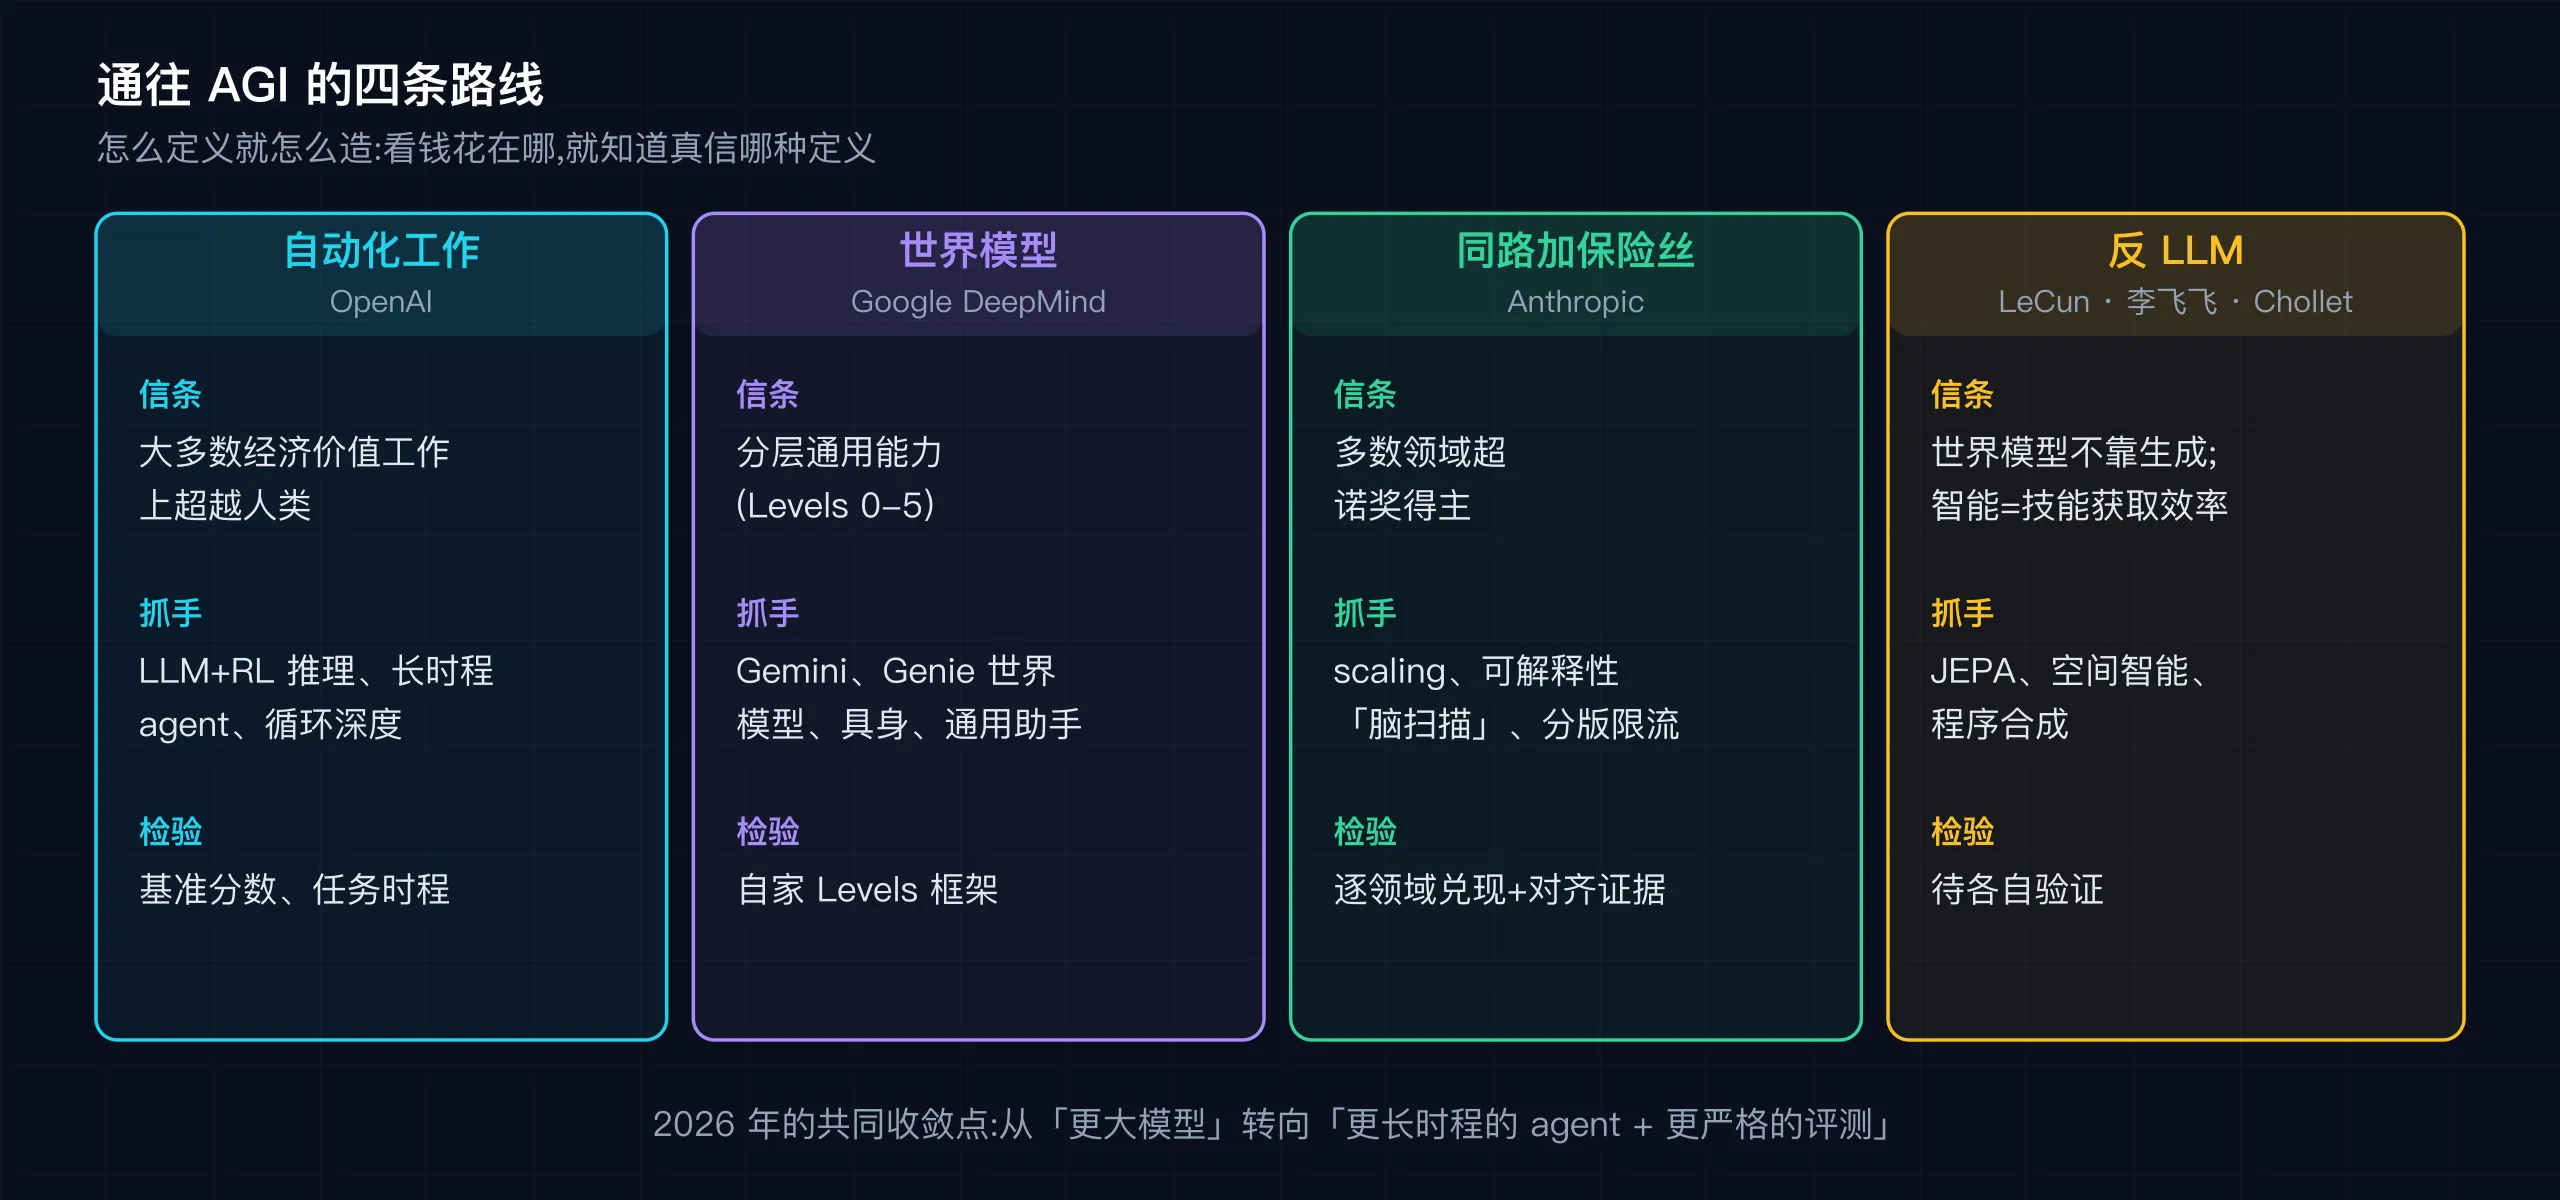
也有收敛的地方:不管信哪条路线,2026 年的前沿都把资源从「更大模型」挪向了「更长时程的 agent + 更严格的评测」。METR 的「任务时程」测量最直观——模型能以一半成功率独立扛下、人类专家要干多久的活:2023 年的 GPT-4 只能扛 5 分钟量级,如今的 GPT-5 已经能扛 2 小时 17 分——基准分数刷爆之后,「能不能独立把活干完」才是新的稀缺指标。
回到 Astra:它到底算不算
带着上面的地图再看 Astra,把各家的尺子一起搬来:
| 尺子 | 标准 | Astra 的读数 |
|---|---|---|
| OpenAI 章程 | 大多数经济价值工作超人类 | 无证据:长程工程基准 FrontierSWE v2 第一名仍是 Claude Fable 5.1(56.29%),Astra 前代居次(frontierswe.com,第三方数据) |
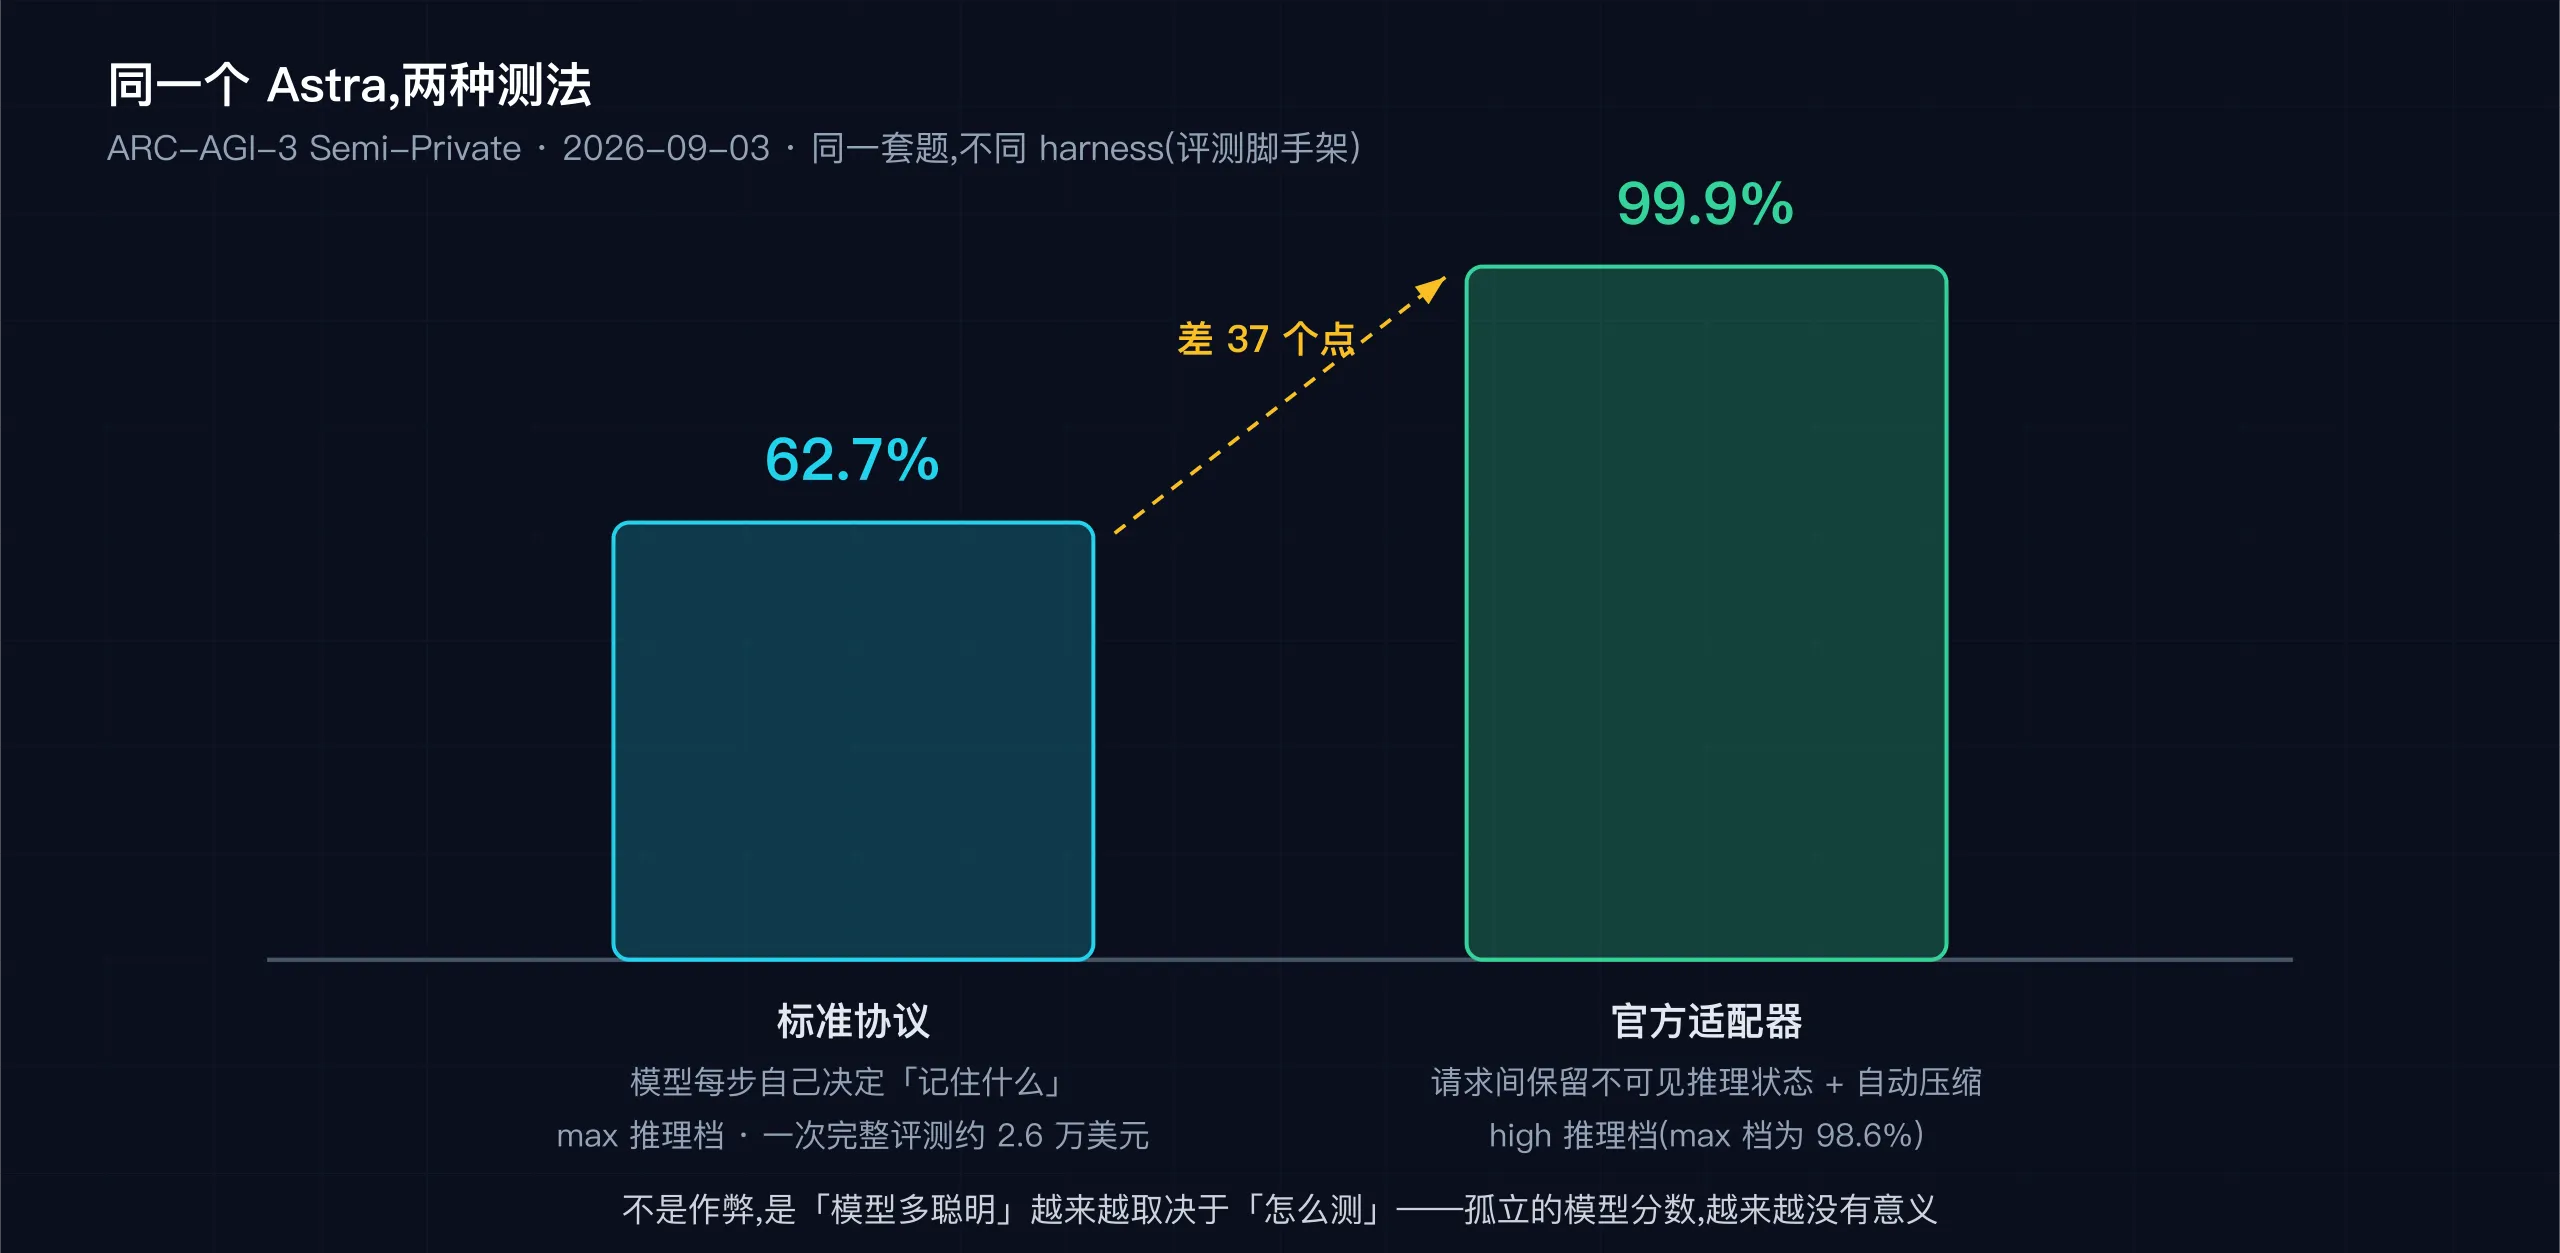
| ARC Prize | 获得新技能的效率 | 标准协议 62.7%,换官方适配器 99.9%,ARC 明确拒绝 AGI 判定 |
| METR 时程 | 能独立干多长的活 | 尚未测量(截至 9 月 4 日);GPT-5(2025 年)为 2h17m |
| DeepMind / 诺奖线 | 分层通用性 / 多领域超诺奖师 | 网安、数学单点极强(见下),「通用」举证未完成 |
两段展开。ARC 那组数字是本周最值得从业者细读的实测(ARC 官方博客):同一套题,标准协议(模型每步自己决定记住什么)开满推理档(max)得 62.7%,一次完整评测约 2.6 万美元;换上官方适配器(OpenAI 自家的上下文管理:请求间保留不可见推理状态、自动压缩历史)就跳到 99.9%(high 推理档;max 档为 98.6%)。这不是作弊,而是暴露了一个行业性问题:当智能越来越依赖「模型 × harness(评测脚手架)」的组合,孤立的模型分数就越来越没有意义——看到任何惊人分数,先问「谁测的、用的哪个 harness」。ARC 同时说这是「阶跃式变化」,但明确表示饱和 ARC-AGI-3「不是实现 AGI 的证明」,下一代基准要测「递归自我改进」和「开放式创新」。
数学是 Astra 最硬的战绩:「相邻素数最小间隔上限」从张益唐 2013 年的 7000 万、到 Maynard 与 Polymath 项目的 246,保持了十余年;最近先由数学家 Julia Stadlmann 压到 240,随后 Astra 的成果把上限改写为 186(见 r/math 与数学家 Thomas Bloom 的转帖)。但单点突破恰恰说明它还是「单科天才」——通用性才是 AGI 的入场券。
再看看 OpenAI 自己的口径,你会发现它比标题党克制得多:
| 谁 | 说了什么 | 性质 |
|---|---|---|
| Sam Altman(CEO) | AGI 是「定义很烂、无关紧要的营销词」;OpenAI「还没到」,但年内或有「可称之为 AGI 的内部系统」 | 未宣布,且亲手拆台 |
| Greg Brockman(总裁) | 「两年后回看,这一刻可能被记为 AGI 诞生期」 | 展望修辞,非宣布 |
| Jakub Pachocki(首席科学家) | 现役模型计算图深度在 GPT-4 两倍内 | 反而是在给能力降温 |
| 官方博客与系统卡 | 通篇零 AGI 宣布;宣布网安 Critical 定级(生物/化学另列 High)+ 限流 + 放缓节奏 | 无宣布 |
圈外的反应同样没有背书:Hassabis 坚持 AGI 在 2029–2030;Amodei 一边给「诺奖线」一边说 AGI 听起来像营销词;LeCun 认为整条 LLM 路线到不了;评测机构 ARC 明确拒绝判定、METR 干脆还没测;Tech Policy Press 的概括最直接:多数研究者并不认为 AGI 迫在眉睫。
所以结论清晰:没有任何权威第三方称 Astra 为 AGI,OpenAI 官方也没宣布。它的营销物料倒是喊出了「欢迎来到 AGI 时代」——但那是修辞和标题,不是宣布。反过来把这一周读成「纯营销」也不对:阶跃式的能力进步、素数纪录、第一个「危险级」定级,都是真的。能力是真的,标签是虚的。
普通用户的 AGI 话术识别清单
下次再看到「AGI 来了」,先过这五问:
- 谁的定义? 用的是章程、诺奖线、层级框架、还是 ARC 那类基准?同一个模型换个定义结论就翻面。
- 谁测的? 自家框架自家评的分数,先当广告看。记住这组数字:标准协议 62.7%,换上官方适配器 99.9%——看到惊人分数,先问「用的哪个 harness、谁跑的」。
- 单领域还是通用? 网安 Critical、数学纪录,都是「单科满分」。AGI 的「G」考的是全科。
- 当下声明还是未来修辞? 「两年后回看就是 AGI 诞生期」这种话永远无法证伪;「我们宣布 AGI」才是声明。目前连一个都还没有。
- 他有什么动机? 融资、招聘、合同、限流的合规叙事……AGI 是史上最廉价的标题,因为没人能为它开罚单。
比追问「是不是 AGI」更有用的,是盯这三个可证伪的指标:
- METR 任务时程——等 Astra 的测量值出来,看它落在 2 小时档还是头部模型的十几小时档(METR 自己提醒:超过 16 小时的测量在当前任务套件上还不可靠);
- ARC 下一代基准——「递归自我改进 / 开放式创新」,检验标准自己也在进化;
- 路线验证的硬时间点——AMI Labs 的世界模型能不能拿出 LLM 做不到的结果、Genie 系环境里训出的 agent 能不能迁移到现实、以及任何一家实验室第一次正式宣布 AGI(那将同时触发监管与合同的连锁反应)。
写在最后
回到开头的热闹:Astra 刷屏的一周里,真正发生的事是——第一家实验室给自己的模型标出「危险级」,三家公司不约而同选择「能力分级、访问限流」(OpenAI 限流加放缓节奏,Anthropic 把 Mythos 圈给审核机构,Google 用 Fairwind 把攻击向能力留给「可信防御者」),首席科学家公开捍卫思维链可监控性。能力竞赛军备化、安全流程公开化,这才是本周真正的新闻,AGI 标签反而是最不重要的部分。
AGI 更像地平线而不是终点线:你朝它走,它就随你的定义往后退。四条路线都在朝各自的地平线赶路,谁先到,取决于谁的定义先被现实兑现。也许等它真到的那天,没人会再用它当标题——因为那天真正的新闻,会是别的东西。
延伸阅读:上一篇《探针 1|为什么你每次问大模型,答案都不一样》 https://mp.weixin.qq.com/s/72whbs2w_Afrt-TUJrwOWg
附:事实核查说明
- 一手源:OpenAI Path to Astra、Critical 网安能力说明、放缓节奏声明;Pachocki X 原帖;ARC Prize 博客;METR 榜单;微软官方博客;Anthropic 发布页;DeepMind Genie 3 与 Project Astra;OpenAI 章程;Levels of AGI 论文。
- 二手转述(已交叉核对,口径以原访谈为准):Brockman 与 Mark Chen 表述见 Guardian、华尔街见闻(转 TIME);训练规模与限流见 Axios;Altman 表述见 Guardian、Sources;Amodei「营销术语」见 Business Insider;LeCun 与 AMI Labs 见 TechCrunch 与 FT;「循环深度」见 TechCrunch 与 The Information 报道;「全自动研究员」见 MIT Technology Review;FrontierSWE v2 见 frontierswe.com;AGI 条款删除见 The Verge 报道。
- 时效声明:本文写于 2026-09-04。METR 尚未公布 Astra 的任务时程;ARC-AGI-3 全量排行仍在更新;若后续有变,以最新一手源为准。