决策模型 Jev 全拆解
先一句话说清主角:Jev 是 TypeSafe AI 9 月 16 日发布的新品类「System One 模型」(官方品类名,社区通称「决策模型」)——不生成文本:给它一段文本,它百毫秒级返回一组带概率的判断(是/否的概率、选项的概率分布、等级评分),专门替 Agent 干「判断」这种高频小活。
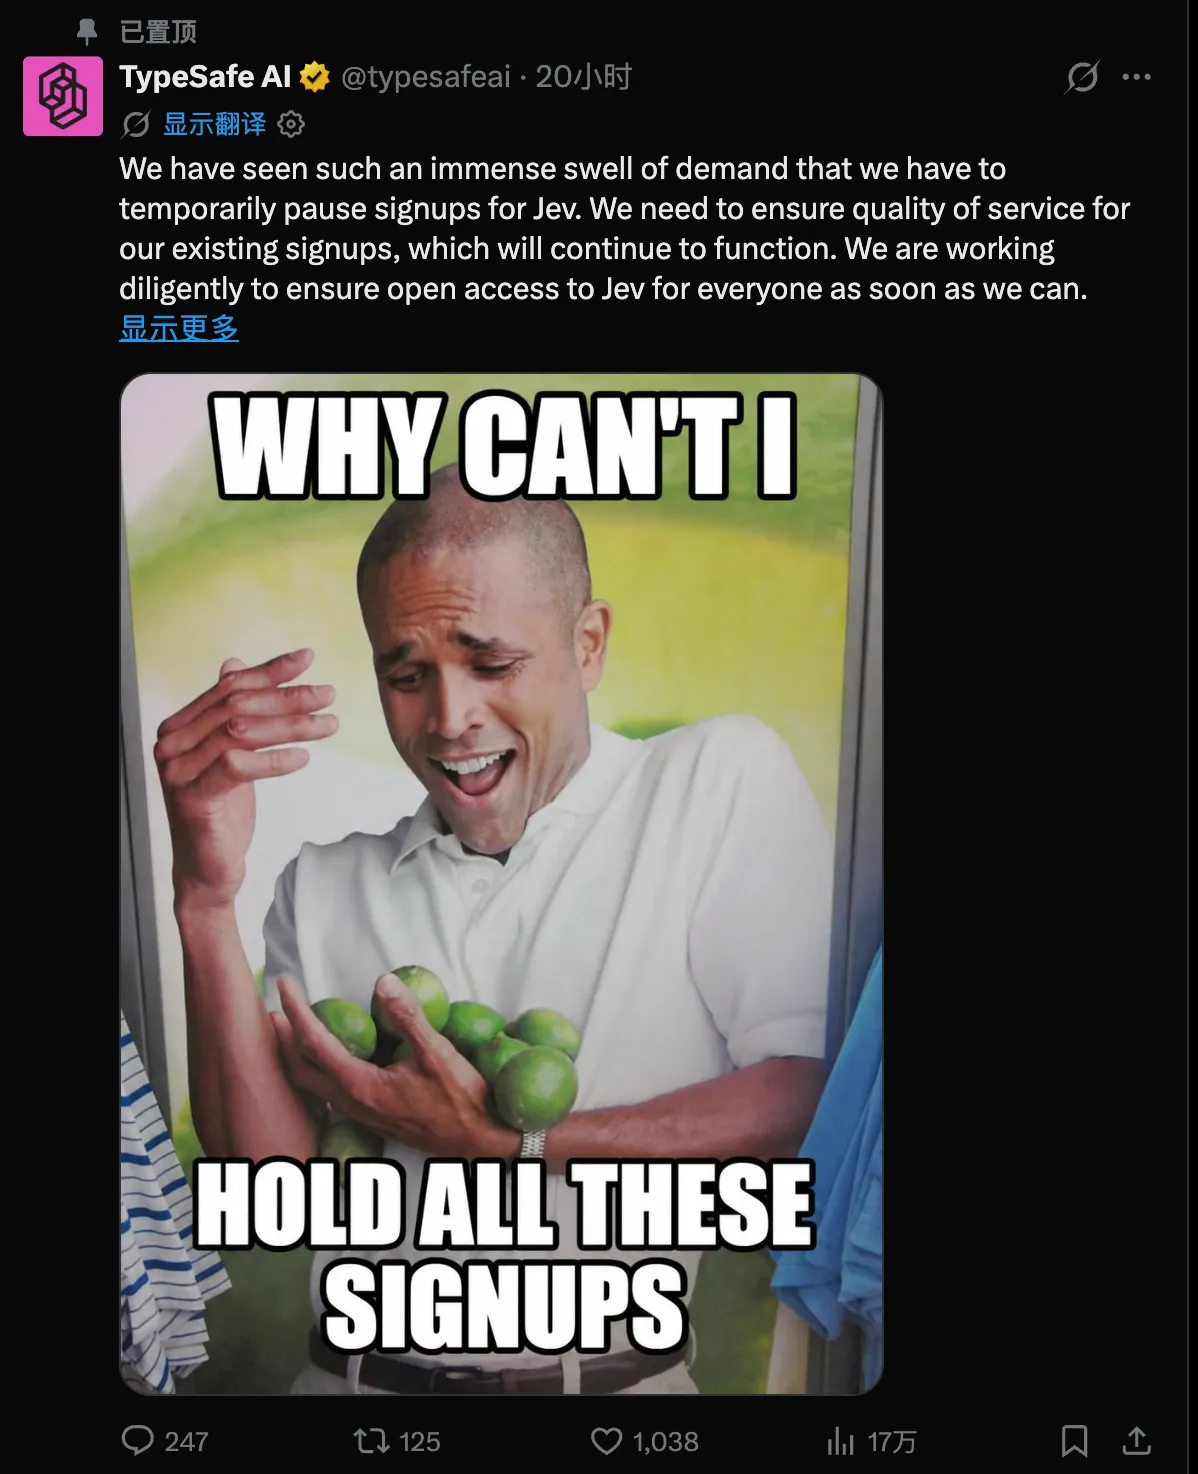
9 月 23 日,TypeSafe AI 的官方账号把一条公告置了顶:想注册 Jev 的人太多,注册通道暂时关闸,「我们要先保证已注册用户的服务质量」。配图是一张老梗图——一个人抱着一堆青柠,配字 WHY CAN’T I HOLD ALL THESE SIGNUPS(我抱不住这么多注册用户)。
值得关闸的产品,9 月 16 日(北京时间)才开放候补。这一周里:
- 9 月 18 日起,LangChain 连发教程把它接进自家体系;
- 9 月 21 日,Simon Willison 撰文背书,采纳 Maggie Appleton 提议的「decision models(决策模型)」作为品类通称;同日创始人 Diogo Almeida 在 Latent.Space 访谈里披露,上线不到一周日处理 token 已超万亿(官方口径),主持人 swyx 插话称 Discord 已约 10 万人、克隆已有约 50 个,创始人笑称自己不跟踪这些数;
- 9 月 23 日,注册爆满关闸,不过并非无门可入:Jev 已可经 Vercel AI Gateway 转发调用(怎么调见文末快答);它的 Hacker News 发布讨论帖拿到 1969 分、511 条评论(截稿时)。
热闹归热闹,这篇想认真回答两个问题:这个新品类,是不是真的把一样东西从大语言模型里拆了出来?拆出来的这个部件,肚子里装的到底是什么?先把口径钉死:TypeSafe 至今没有发布官方 benchmark 分数或榜单,官方宣传里的倍数一律标注「官方称」。哪些是事实、哪些是说法,本文分得清;至于它实测到底行不行(中文场景掉多少、安全门控靠不靠得住),放在下一篇实测篇,这里专注原理与祛魅。
一、为什么要把「判断」拆出来
跑过 Agent 的人都知道,一个 Agent 循环里真正高频的动作不是生成,而是判断:这封邮件该路由给哪个团队、这条命令要不要人工确认、这段反馈打几分、下一步走哪条分支。这些活今天工程上主流只有两种干法:要么提前写死规则,要么请出一个几百 B 参数的大语言模型来当裁判(LLM-as-judge)。
前一种覆盖不了长尾,后一种在工程上有三笔明码标价的账:
- 贵:裁判每判一次都按生成 token 计费,解释往往比输入还长;
- 慢:自回归模型逐字吐字,一次判断动辄秒级;
- 不稳:同一输入采两次样,结论可能不一样,裁判自己还需要被裁判。
当 Agent 循环每一步都要过一道裁判,这三笔账就乘在了每一次迭代上。
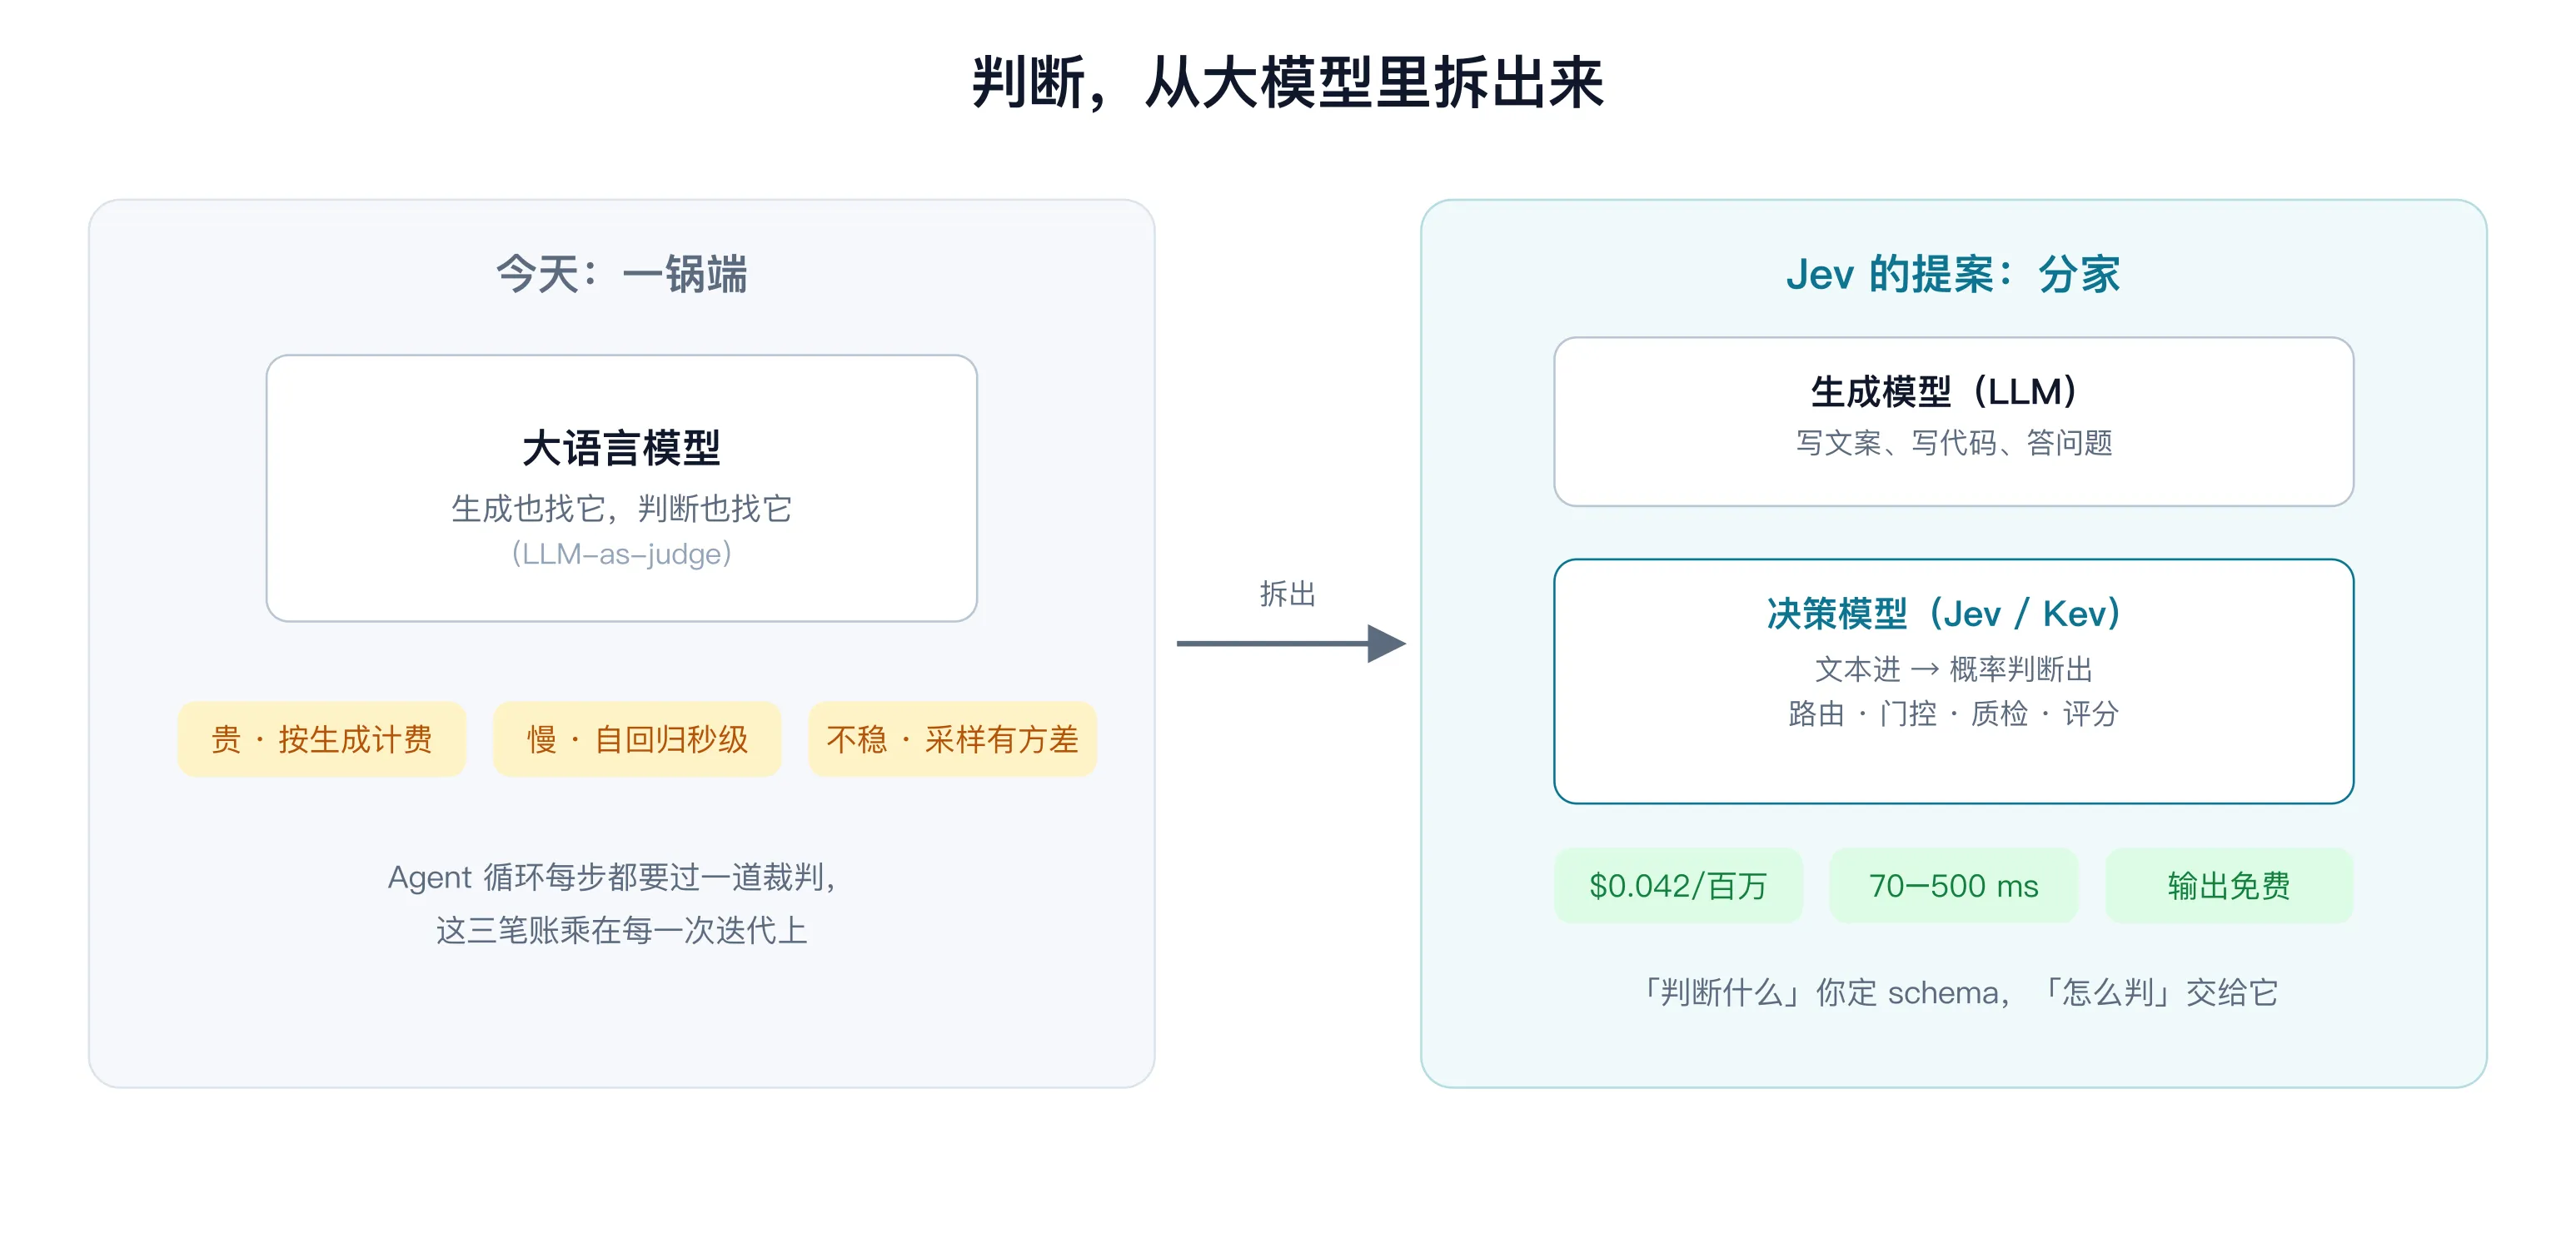
LangChain 的教程《Building a Harness with Jev》把场景摆得很具体:模型路由、工具风险门控、Agent 循环内的快速决策。Jev 给出的答案,是把「判断」做成一种独立的模型品类:文本进、概率判断出,一次请求把一组问题并行评完。官方博客的说法是,比用大语言模型做同样判断快 40–200 倍、个别场景便宜约 444.6 倍——一快一省,均为官方称,目前没有第三方 benchmark 可对照。
命名本身就藏着产品哲学。System One 取自卡尼曼《思考,快与慢》里的「系统一」:快、省力、不过脑子的直觉判断。Jev 则取自经济学家杰文斯——效率暴涨反而催生更大总用量的「杰文斯悖论」,创始人的押注是:判断一旦便宜到几厘钱一次,用判断的地方会多到今天无法想象。Latent.Space 那期访谈的标题把这个定位压缩到了极致:「for Prod, not God」(为生产,不为神)。
二、文本进、概率出:一次调用长什么样
一次调用长这样。Jev 注册暂停,这里用同协议的开源复刻 Kev-0.8B(Jared Palmer 的项目,见第五节)发真实请求演示——请求格式与发给 Jev 的一字不差:
{
  "state": "你好,我的 Stripe 账户连了三天一直失败,订单都在流失……",
  "questions": {
    "department": {"type": "choice", "instructions": "该交给哪个团队处理",
      "criteria": {"billing": "支付或订阅问题", "technical": "故障或集成报错", "sales": "定价或账户咨询"}},
    "frustration": {"type": "score", "instructions": "客户的不满程度",
      "criteria": ["平静,只是陈述事实", "不满但语气克制", "非常愤怒,措辞激烈"]},
    "is_urgent": {"type": "noul", "instructions": "这条消息表达了紧迫性"}
  }
}
一个 state(待判断的上下文)加一组 questions,一次请求并行返回全部答案。题型只有三种:
- noul(是非题):直接给 P(成立),一个 0–1 的概率;
- choice(选择题):给全部选项的概率分布,附一个置信度;
- score(评分题):给期望分。
那上面这三个问题(department、frustration、is_urgent)是谁定的?调用方定的。 每个问题的 key、题型、判断标准(criteria)都要你在请求里显式写明。Jev 不发明问题,也不猜你想问什么,你问什么它答什么。示例里的三问来自官方 quickstart 的客服场景:转哪个团队、客户多不满、是否紧急,是业务上的标准分诊维度。换句话说,「判断什么」是你的 schema 设计(像设计数据库表结构),「怎么判」(读完这段文本、按你的定义算出各答案的概率)才交给 Jev 这样的决策模型。这正是这个品类划下的分工边界:业务维度在你手里,概率计算在模型那头。
官方口径:端到端 70–500 毫秒、上下文 32k、输入 $0.042/百万 token、输出免费。「输出免费」本身就在提示商业模式:这里几乎没有生成,自然没得收。
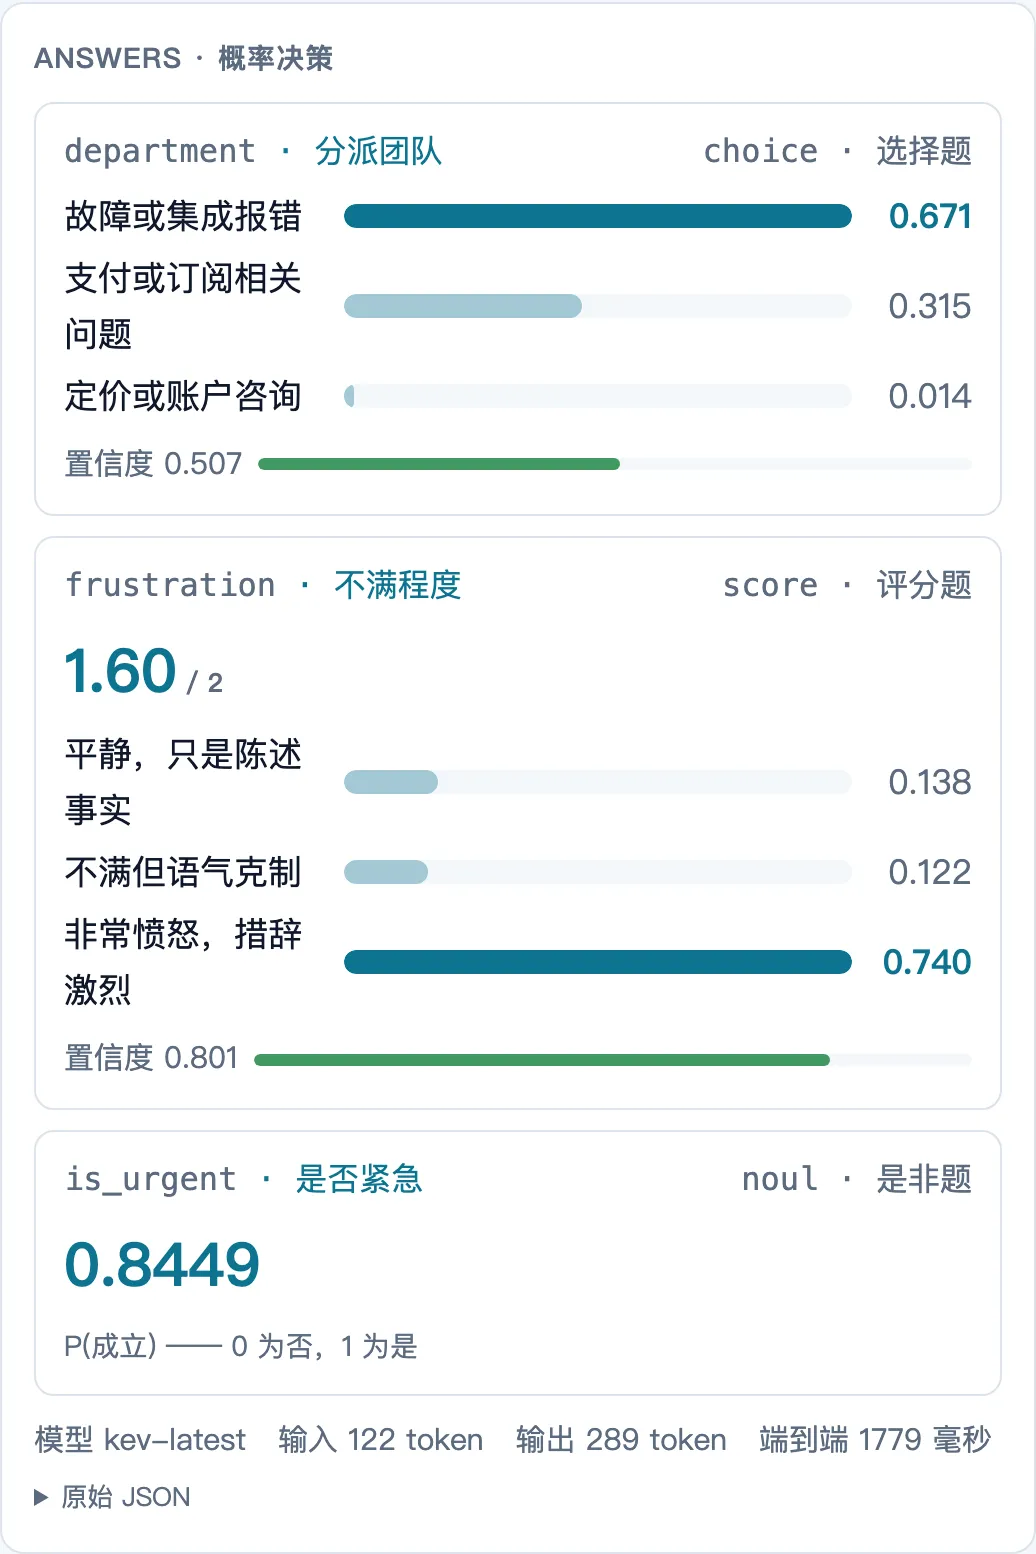
我们在本机用 Kev-0.8B 发了上图这次真实请求:中文工单,三个问题并行,端到端约 110 毫秒,输入 122 token、输出 289 token。那 289 个「token」是概率数字而非文本——这正是与 LLM 的本质区别:没有自回归,没有逐字生成,判断是一次前向计算。创始人对定位的说法是「像数据库,不像 AI 同事」,最好能「像正则表达式一样毫无存在感」(Latent.Space 访谈及 show notes)。
三、拆开看:置信度其实是个算术公式
Jev 的返回里,每个选择题都带一个 confidence 字段,0 到 1,看起来像模型对「我这次有多确定」的独立估计——对大模型做置信度校准是正经研究方向,没人会怀疑这里藏着核心技术。
9 月 17 日,独立研究者 Archer Hume 发布黑盒逆向《Jev’s Architecture Unmasked》:他对 Jev 发起约一万次 API 调用,找到了 confidence 的来源——它不是模型输出,是一道算术:
c = (p_max − 1/K) / (1 − 1/K)把每个符号摊开:K 是选项数;p_max 是领先选项的概率;1/K 是「完全瞎猜」时每个选项的概率基线——三个选项就是 1/3,你闭着眼也会分到这么多。分子(p_max − 1/K)问的是:领先答案比瞎猜基线高出多少;分母(1 − 1/K)是这个超出量的天花板:p_max 最多到 1,超出量最多也就 1 − 1/K。两者一除,得到「把握占满格的比例」,天然落在 0 到 1:
- 模型完全懵,概率摊平(p_max = 1/K)→ 分子为零,c = 0;
- 模型全押一个答案(p_max = 1)→ 分子分母相等,c = 1;
- 中间线性过渡。三个选项、最高概率 0.8:超出基线 0.8 − 1/3 ≈ 0.47,满格 2/3 ≈ 0.67,置信度 0.7。
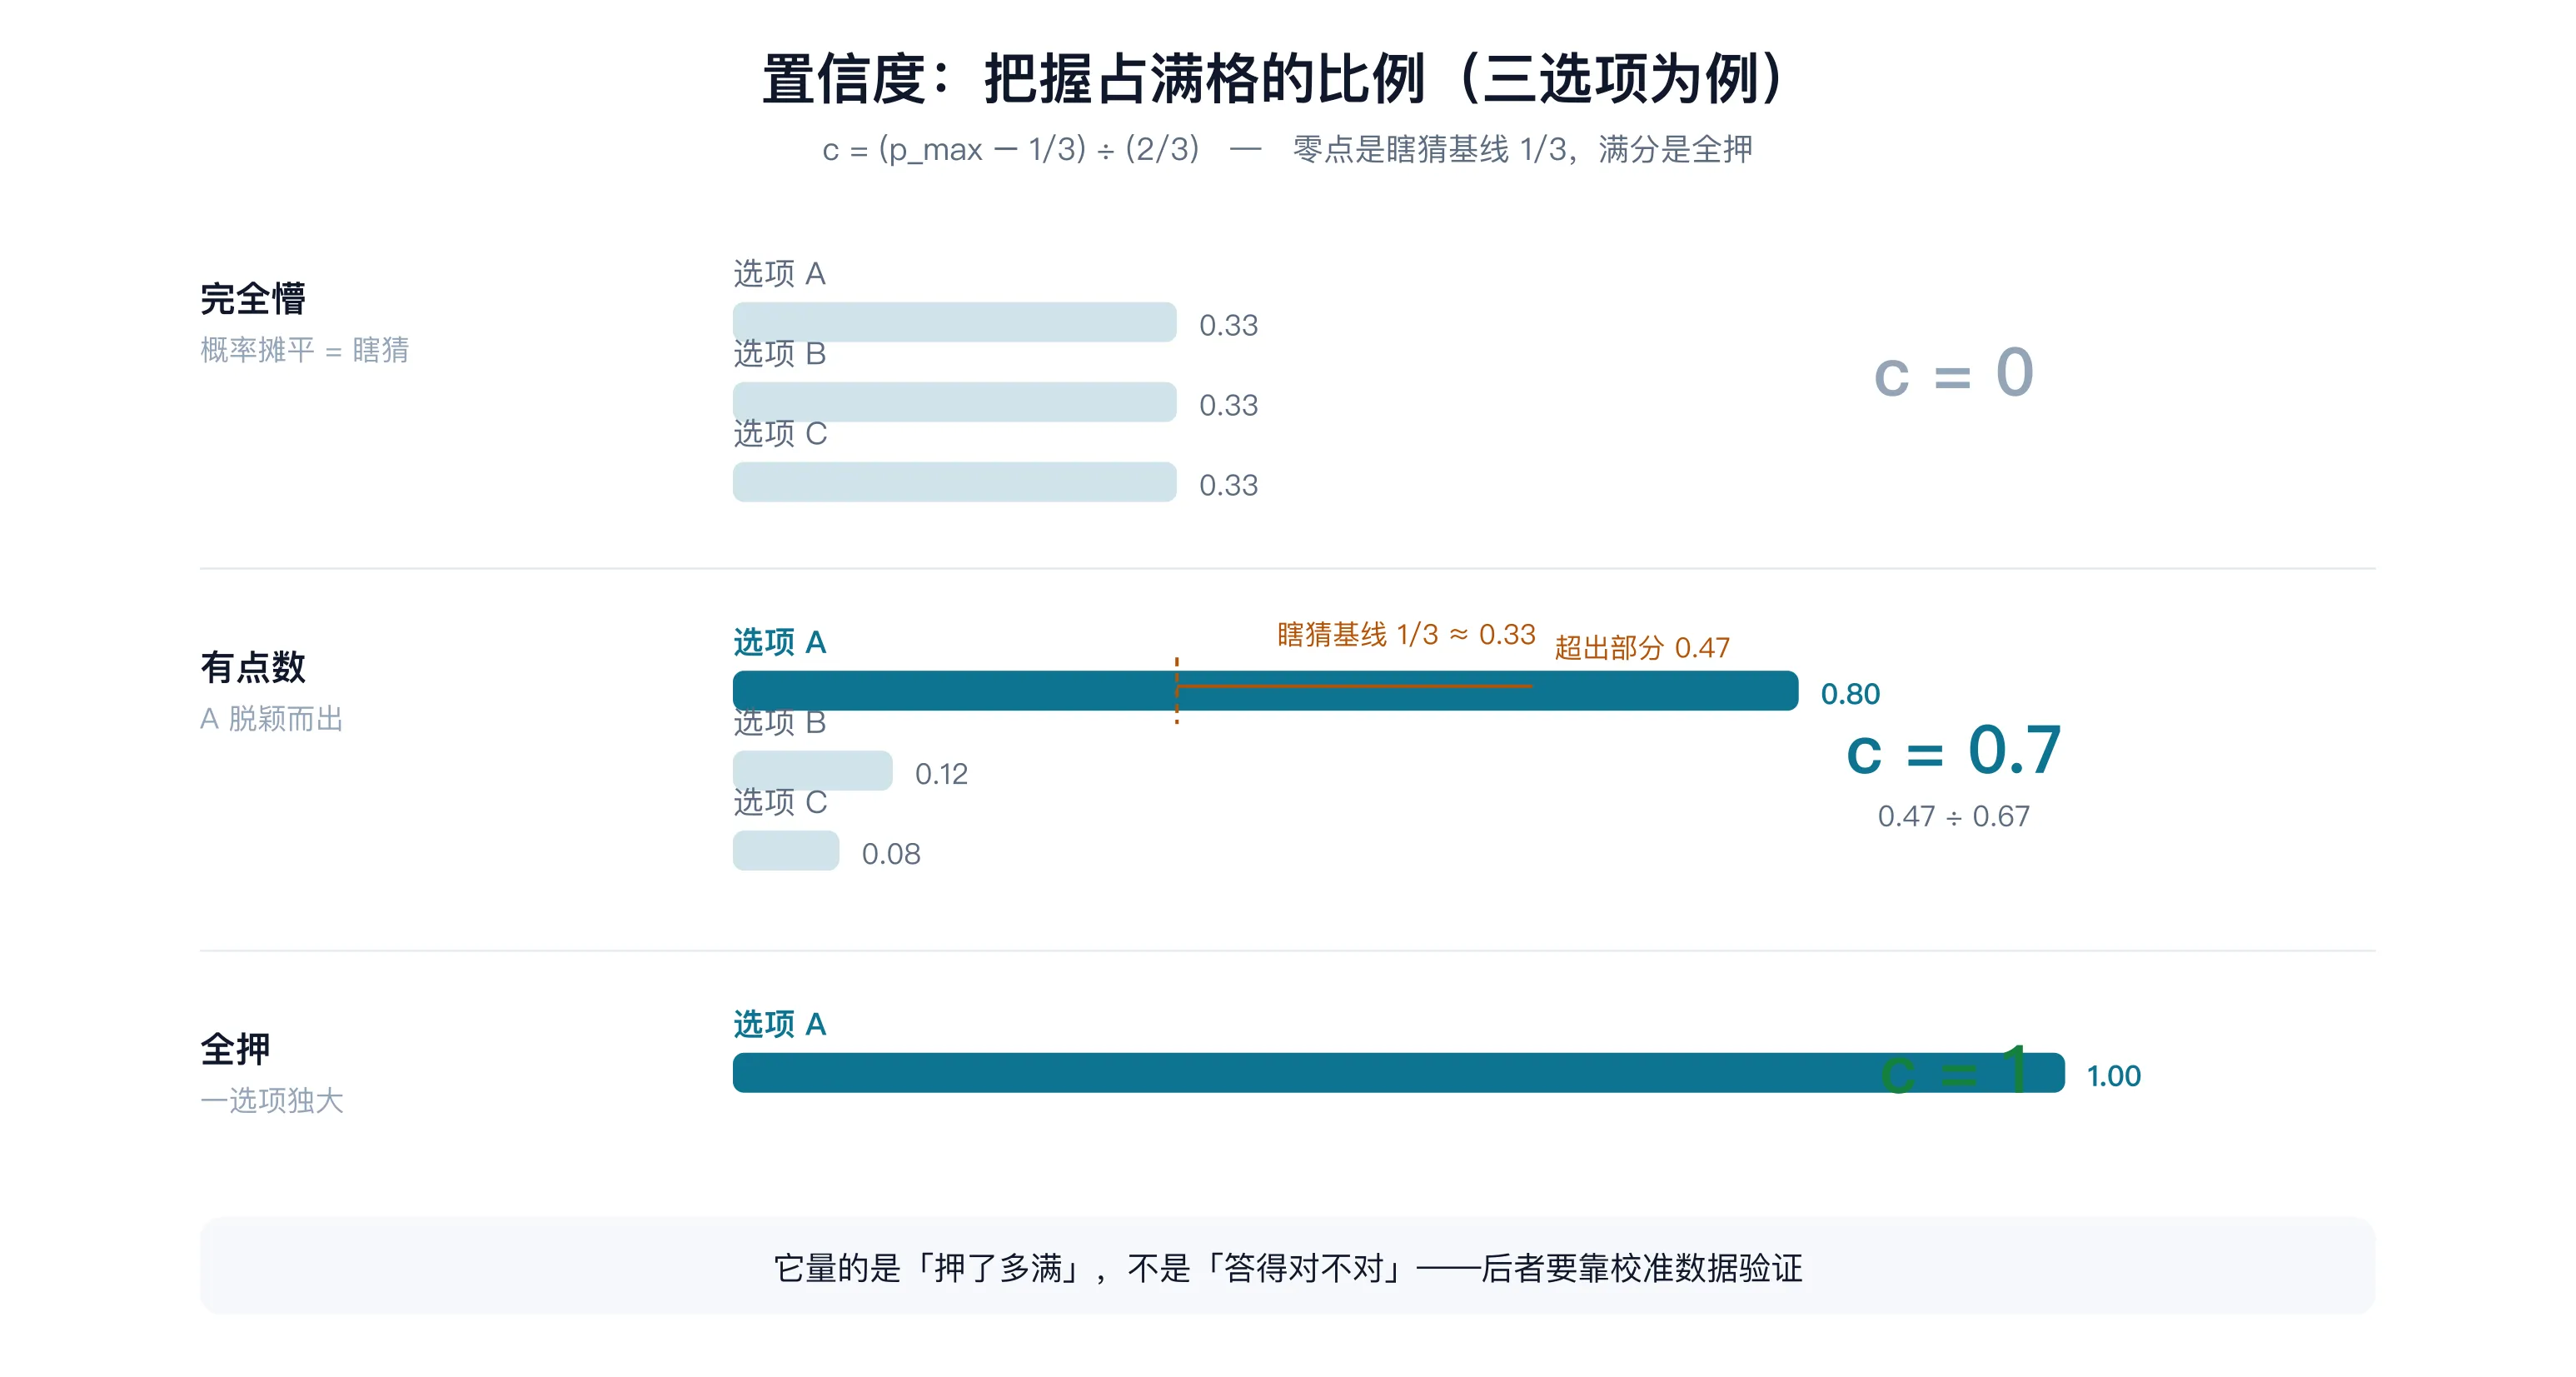
一个常见的误读要在这里钉死:这个公式算的不是「这次答对的概率」,而是「模型自己押了多满」。它只量概率分布的形状——答案之间拉开差距没有,跟答案对不对是两回事;「说的把握」能否兑现成「实际正确率」,要靠下一节的校准数据来验。原文也强调,它「不是另一个学出来的正确性估计」。
这道公式也透露了它的选择哲学。置信度不产生新信息,只是概率分布的另一种读数——像温度计之于同一团空气:换了个刻度,不是新测量。设计者没有训练一个「自我评估头」让模型估计自己(那会掉进「评估者还需要被评估」的递归),而是用一道除法把分布形状压成标量:任何调用方都能从 probabilities 手算出 confidence,零黑箱。这和它「像正则表达式一样毫无存在感」的定位是一路的:连置信度都无聊得可以。
标尺的零点也有讲究:不是 0,而是「瞎猜基线」1/K。类比考试:一道三选一的选择题,完全不会也能蒙到 1/3 的「概率」;confidence 量的是你从瞎蒙里杀出来的那部分——同样 0.51 的领先,二选一里只折算成 0.02 的把握(刚过半不算本事),五选一里折算成 0.39(从五个选项里杀到过半,算真有点数)。把握的定义,是超出无知的部分。 工程上这个数字就是路由开关:低于阈值,就降级、转人工、或者换更大的模型。
我们拿自己的数据验算了这道题:上图 department 题最高概率 0.6715(图中显示为四舍五入的 0.671),代入公式得 0.5073——与 API 返回的 confidence 精确一致。换三组不同输入再验(英文工单、中文工单、另一组中文问题),choice 的置信度全部精确落在公式值上。
这里要把两件事分开,它们经常被混为一谈。一是概率本身校准得好不好:逆向者用 1200 道 MMLU 题测得十桶校准误差(ECE)0.0313,相当好的水平。二是这个分布自不自信:1200 题里 990 题的概率挤在 0.9–1.0 区间——虽然这一桶预测均值 98.7% 对上了 96.3% 的实际正确率,但一个几乎所有判断都接近「确定」的模型,留给「我不确定」信号的余地很小。校准好与过度自信,可以同时成立。
第三方早期实测从同方向佐证:lindfors.no 的早期测试(9 月 18 日,24 份挪威语文档,参考标注由 Claude 生成)里,Jev 的概率分桶对参考标注相当诚实:0.7–0.9 桶一致率 97%、0.9–1.0 桶 98%。同一实验还试了措辞敏感度:同一批判断,把提问措辞从随手写换成认真改写,ECE 从 0.040 涨到 0.116——校准虽好,措辞仍是变量。
至于「公式算置信度算不算糊弄」,摆事实即可:confidence 字段没有虚报信息,它如实反映了概率分布,只是也仅仅是个换算。但一个叫 confidence 的字段,会让人以为它携带了概率分布之外的额外信息。知道它是算术,用的时候就不会对它有过剩的期待——这是这篇逆向最实用的结论。
四、肚子里是谁:指纹、自报与读出头
逆向文章接着回答了所有人好奇的问题:Jev 到底是谁家的底座、多大、怎么读出概率。
证据一,tokenizer 指纹:不同 tokenizer 切同一段文本会得到不同的 token 数,这构成了类似指纹的识别手段。逆向者用 415 组探测对照了 192 个公开词表,没有一个完全匹配;最接近的是 Qwen,415 次里一致 348 次。能下结论的只有一句:这不是某个公开模型套壳时原封不动的词表,但不排除能力源自 Qwen 系血统或其衍生。
HN 上有个流传更广的彩蛋:有人把「你是什么模型」做成字母选项让 Jev 挑,它挑了 Qwen。不过同一批讨论里也有人提醒,语言模型对「我是谁」的自报本来就极不可靠,这条路只能当段子看(以上为社区讨论观点,非逆向结论)。
证据二,选项交互实验:如果 Jev 是「每个选项挂一个独立二分类头」,改动无关选项的措辞不该影响其他选项的概率,实测会动。这更像是另一种读出方式——把全部选项放进上下文,以类似指针(pointer)的方式一次读出整个分布(原文两种解释并存,这一种略占优)。
证据三,延迟与吞吐:约 30k token 的输入 160 毫秒处理完,同样的吞吐量,一个稠密 70B 模型在 8×H100 节点上大约要一秒——实测约 6 倍,与官方「快两个数量级」的方向一致、未到其口径。逆向者的推测是稀疏 MoE,激活参数 10B 量级。
逆向者自己给的最终画像是一句克制的技术描述:「因果 transformer,共享的 state 前缀,相互隔离的问题后缀,逐列表处理选项,类型化数值读出;稀疏专家很可能是骨干,但设计中没有其他部分依赖它们。」翻译成人话:一套务实的已知组件新组合——既不是开创范式,也不是「套壳」两个字能打发的。
五、它真的新吗:先例、反方、定调与竞品格局
文本分类器不是新东西,HN 的争论里正反两方把家谱都翻出来了。反方说这就是「vibe coder 刚发现分类器」:CLIP 早就做了开放词表分类,flan-t5 早就能按指令输出结构化答案,GLiNER 是现成的零样本实体分类器;还有 ModernBERT 底座的开源决策模型 Laya(421M 参数,约 33 毫秒)——只是上下文只有 512–1024 token,撑不起 Jev 那种 32k 长工单。HN 有用户直言「就是 BERT 加数据」(社区观点)。
正方的定调来自 swyx(Latent.Space 主理人):意义不在「又一个分类器」,而在第一次有人把「通用基础分类器」做成了产品化基建,就像基础模型之于生成;任务专用的 BERT 复刻,misses the point。这其实正面回答了开头的问题一:「把判断拆出来」拆的不是一层新架构,而是一个新品类的基础设施位——判断第一次像数据库一样可以被独立采购。市场用脚投票:访谈时点 swyx 称克隆已约 50 个(经核实的有 von、mini-jev、jev-leftpad 等),还有关于大厂会不会 fast-follow 的认真讨论(HN 285 分、204 评,截稿时)。
官方这边有两个值得记录的事实。一是坚决不公开 benchmark,创始人给的理由是基准「极易被博弈」,代价是外界只能拿延迟数据和第三方逆向来拼图。二是生态背书数据要小心读:LangChain 实验里「与人类判定 100% 一致、方差低 92–913 倍」的结论,样本量只有 5 条——方向可以参考,数字当不了证据。
| 玩家 | 形态 | 关键数据(均为各自官方口径) |
|---|---|---|
| Jev(TypeSafe) | 托管 API | 官方称快 40–200 倍;HN 用户体感迁移后负载成本约 1/10 |
| Kev(Jared Palmer) | 开源 0.8B/4B/9B | Kev 官方评测(非受控):新来源 dev 集 0.822 对 Jev 0.857;MMLU 0.74 对 0.90 |
| Laya(Convai) | 开源 ModernBERT+RL | 421M 参数、约 33ms;上下文仅 512–1024 token |
| 社区克隆 | von、mini-jev、jev-leftpad 等 | 访谈时点约 50 个(swyx 口径),仍在增加 |
| 大厂 | 未出手 | HN 高分帖认真讨论 OpenAI fast-follow 路径 |
六、快答
把散在全文的判断压成快问快答。
Jev 的数字都能信吗?分两层:延迟和价格是可独立验证的工程参数(逆向实测对得上量级);倍数与官方质量声明均来自官方口径,至今没有第三方 benchmark——LangChain 的「与人类 100% 一致」是第三方实验,样本只有 5 条。
confidence 字段是模型「想」出来的吗?不是,是概率分布的算术换算(第三节公式),信息量等于分布本身,不多一分。
「日 token 超万亿」含金量如何?创始人的原话是夜间也有大量机器在调用、不只是人在试用;若属实,说明它已经在生产管线里当零件用,比任何 demo 都有说服力——但这句话本身仍是官方口径。
普通开发者现在怎么用上它?它是组件不是产品,直接用户是写 Agent 循环的工程师。CC、ZCode 这类现成工具的内部判断(选工具、走哪步)是产品黑盒,替换不了也没必要替换,那些是生成加推理的混合活,不是它接的纯判断。现实路径三条:等框架和工具厂商集成(LangChain 已接,大厂 fast-follow 在讨论中),间接受益;自己写小工具时把某一环判断外包给它(工单分类、风险分级、内容打标),API 就是一个 curl,让大模型帮你把调用脚本写出来就行;真要深度用,就是在自己的 Agent 循环里接——生成和判断完全可以分家:DeepSeek 写生成,Jev/Kev 管判断(请求路由、输出质检、工具门控),怎么选型看下一篇实测。
现在能注册吗?TypeSafe 直属注册 9 月 23 日起暂停,重开时间未公布;但 Jev 已通过 Vercel AI Gateway 上架转发(模型 ID typesafe-ai/jev,与官方同价),不走 TypeSafe 账号同样能调。
尾声:拆出来了,然后呢
回到标题的问题:Jev 把判断从大模型里拆出来了吗?拆出来这件事本身,市场用一周的爆发和成串的克隆投了票。至于拆出来的东西内部是什么:一道算术公式充当置信度、一个指针式的读出头、一身疑似 Qwen 的血统、一群务实的老组件。它提醒我们,「新品类」的光环和「老零件的新组合」的实质,完全可以共存,而且往往就是共存。
判断拆出来之后,下一个问题永远是:那它实测行不行——尤其中文场景。我们拿开源平替 Kev-0.8B 做了五个场景的实测(含一个中文 2×2 受控实验),下一篇实测篇见。