AI 编程工具为什么上传你的代码:ZCode「索引库」说法全核查
上上周,一位开发者在清理磁盘时发现,AI 编程工具 ZCode 的数据目录占了 700MB 多。里面有个 313MB 的加密文件,旁边的元数据写着:上传失败,已重试 564 次。
他做了一件多数人不会做的事:把这个桌面应用的安装包拆开,逆向了里面的代码。这才发现,那个加密文件是自己一个商业项目的完整快照,连全部 Git 提交历史都在里面。更微妙的是,这个文件因为超过服务端大小限制,从来没传上去过——真正悄悄传成功的,是他另一个只有 15KB 的小仓库。他后来自嘲说:幸亏项目够大。
这件事随后发酵(Hacker News 两个帖子合计近六百分),官方道歉、下线功能、承诺开源。9 月 21 日凌晨代码库真的放出来了,当天早上的公告还附了两份第三方审计结论:云端存储桶已清空,客户端已切断上传链路。
官方对原因的回应,一句话概括:这一切源于「代码库索引」功能。这个说法是整件事里最值得认真对待的部分——因为「AI 编程工具做代码索引」听起来天经地义,谁都需要工具理解自己的代码库。但把官方说法、逆向证据、开源代码三方摆在一起核对,会发现它们对不上。所以这篇不纠缠「该不该骂」,做一次全核查:官方说的「索引库」到底是什么?上传的代码是干什么用的?到底会不会被存储?开源代码能不能回答这些问题?
一、先还原事实:上传是怎么发生的
细节来自发现者 ferstar 的逆向分析,他把闭源客户端逐段确认过。
触发时机:每次你输入提示词之前,客户端自动给整个工作区拍一次全量快照,任务完成时再补一次。不是每天一次,也没有任何开关,唯一的门控是你登录了。
打包范围:整个工作区目录,只排除 node_modules 这类依赖。他那个 345MB 的项目里,.git 目录占了 86.6%——真正的源码和文档只占 13.4%。删掉过的 API 密钥、没推送过的分支名、.git/config 里内网 GitLab 的主机名,全在里面。删除只在你的工作区生效,历史里什么都还在。
上传路径:客户端先向服务器要一张上传凭证(快照 ID + RSA 公钥 + 阿里云 OSS 表单签名),然后绕过自家服务器直连 OSS 把加密包传上去,OSS 回调登记。应用层的日志和风控,对这段流量完全看不见。
开关:设置界面有两个看起来相关的开关,逆向后发现一个只控制「数据是否授权用于训练」,另一个只控制「服务器要不要索引已上传的快照」——打包和上传本身不受任何开关控制。
对 AI 编程工具来说,把代码发给模型是题中之义。但这条通道和「把相关上下文发给模型」是两回事:它是全量的、含全部历史的、每次对话前触发的、无开关的。
二、官方说法:这一切是为了「索引库」
9 月 18 日的情况说明里,官方是这样归因的:问题源于「代码库索引」功能,该功能旨在帮助用户在本地生成仓库索引,以支持包括历史版本在内的会话检查点恢复、历史版本回退及 Repo Wiki 等功能;具体缺陷是 Repo Wiki 功能在生成 Wiki 页面时,「可能」会将仓库数据上传至云端,且该功能上线初期默认开启。
平心而论,这个说法选得很聪明:代码索引确实是 AI 编程工具的常规能力,本地索引也是正当做法——如果索引真的在本地生成,那用户的数据就没有离开机器,剩下的只是「Repo Wiki 生成时可能上传」这个附带缺陷。照这个叙事,问题只是「附带功能默认开启」。
但「可能会上传」三个字,和逆向出来的事实摆在一起,就撑不住了。
三、逆向证据讲的另一个故事
第一处对不上:触发时机。官方说上传发生在「Repo Wiki 生成 Wiki 页面时」;逆向事实是快照捕获挂在 captureBeforePrompt——每次你输入提示词之前就执行,任务完成时再补一次。不是生成 Wiki 时才「可能」上传,是每一次对话之前都在打包。
第二处对不上:索引在哪里做。官方说索引「在本地生成」;但设置里那个「Repo Snapshot Indexing」开关,控制的是服务器要不要索引已上传的快照——如果索引在本地生成,服务器索引什么?开关的存在本身就说明:至少在当时的架构里,索引的消费方在云端。
第三处对不上:打包范围。本地生成代码索引,只需要读源码文件、建词条或向量摘要——任何一种本地索引技术都不需要打包整个 .git 目录(占 86.6%),更不需要把 Git 的提交对象库和 LFS 二进制资产传上去。快照里含全部历史,能服务的功能只有一类:需要在云端重建你仓库状态的东西,比如 Repo Wiki,或者别的什么。
三处证据指向同一个结论:至少在 v3.13 时代,「代码库索引」的真实形态是全量快照上传 + 云端处理,而不是官方口径里那个「本地生成的仓库索引」。顺带说一句,处理这些快照必然要解密——信封加密的私钥只在云端(这正是发现者拿遍本地私钥也解不开自己那份 313MB 密文的原因),所以「云端处理」不是推测,是那套加密架构的直接推论。
至于云端处理完的东西拿去做了什么——Repo Wiki 是官方点名的产品;「数据是否授权用于训练」作为一个独立开关存在,说明训练授权在这个产品语境里是一个真实的数据出口。这两条之间是什么关系,官方没有拆解过。
四、开源考古:说好的「本地索引」在哪里
9 月 21 日开源的代码,给了我们一个此前不可能有的验证手段:官方说的那些功能,到底在不在代码里。
我把整个仓库翻了一遍,搜遍代码索引的全部常见实现形态——向量检索、embedding、语义索引、全文索引——一个都没有。「在本地生成仓库索引」这个功能,在开源版本里不存在。它要么随着 Repo Wiki 一起被整体移除了,要么从未以「本地」形态存在过。无论哪种,都意味着官方回应里那个听起来最无辜的部分,无法在代码里得到印证。
代码里能找到的,是两样别的东西。
第一,修复后的检查点功能——官方口径里「代码库索引」要支撑的那个「会话检查点恢复、历史回退」,现在有了新实现,写在 packages/services/src/git/repo/gitCheckpointRepo.ts:临时 Git 索引收集工作区状态 → write-tree 冻结 → commit-tree 生成提交 → update-ref 挂在 refs/zcode/checkpoints/<工作区哈希>/<快照ID> 的隐藏引用下。不碰你的真实 index、不产生可见分支、快照范围只跟当前工作区,Git 帮你保管、防 GC 回收,随时 diff 随时恢复。
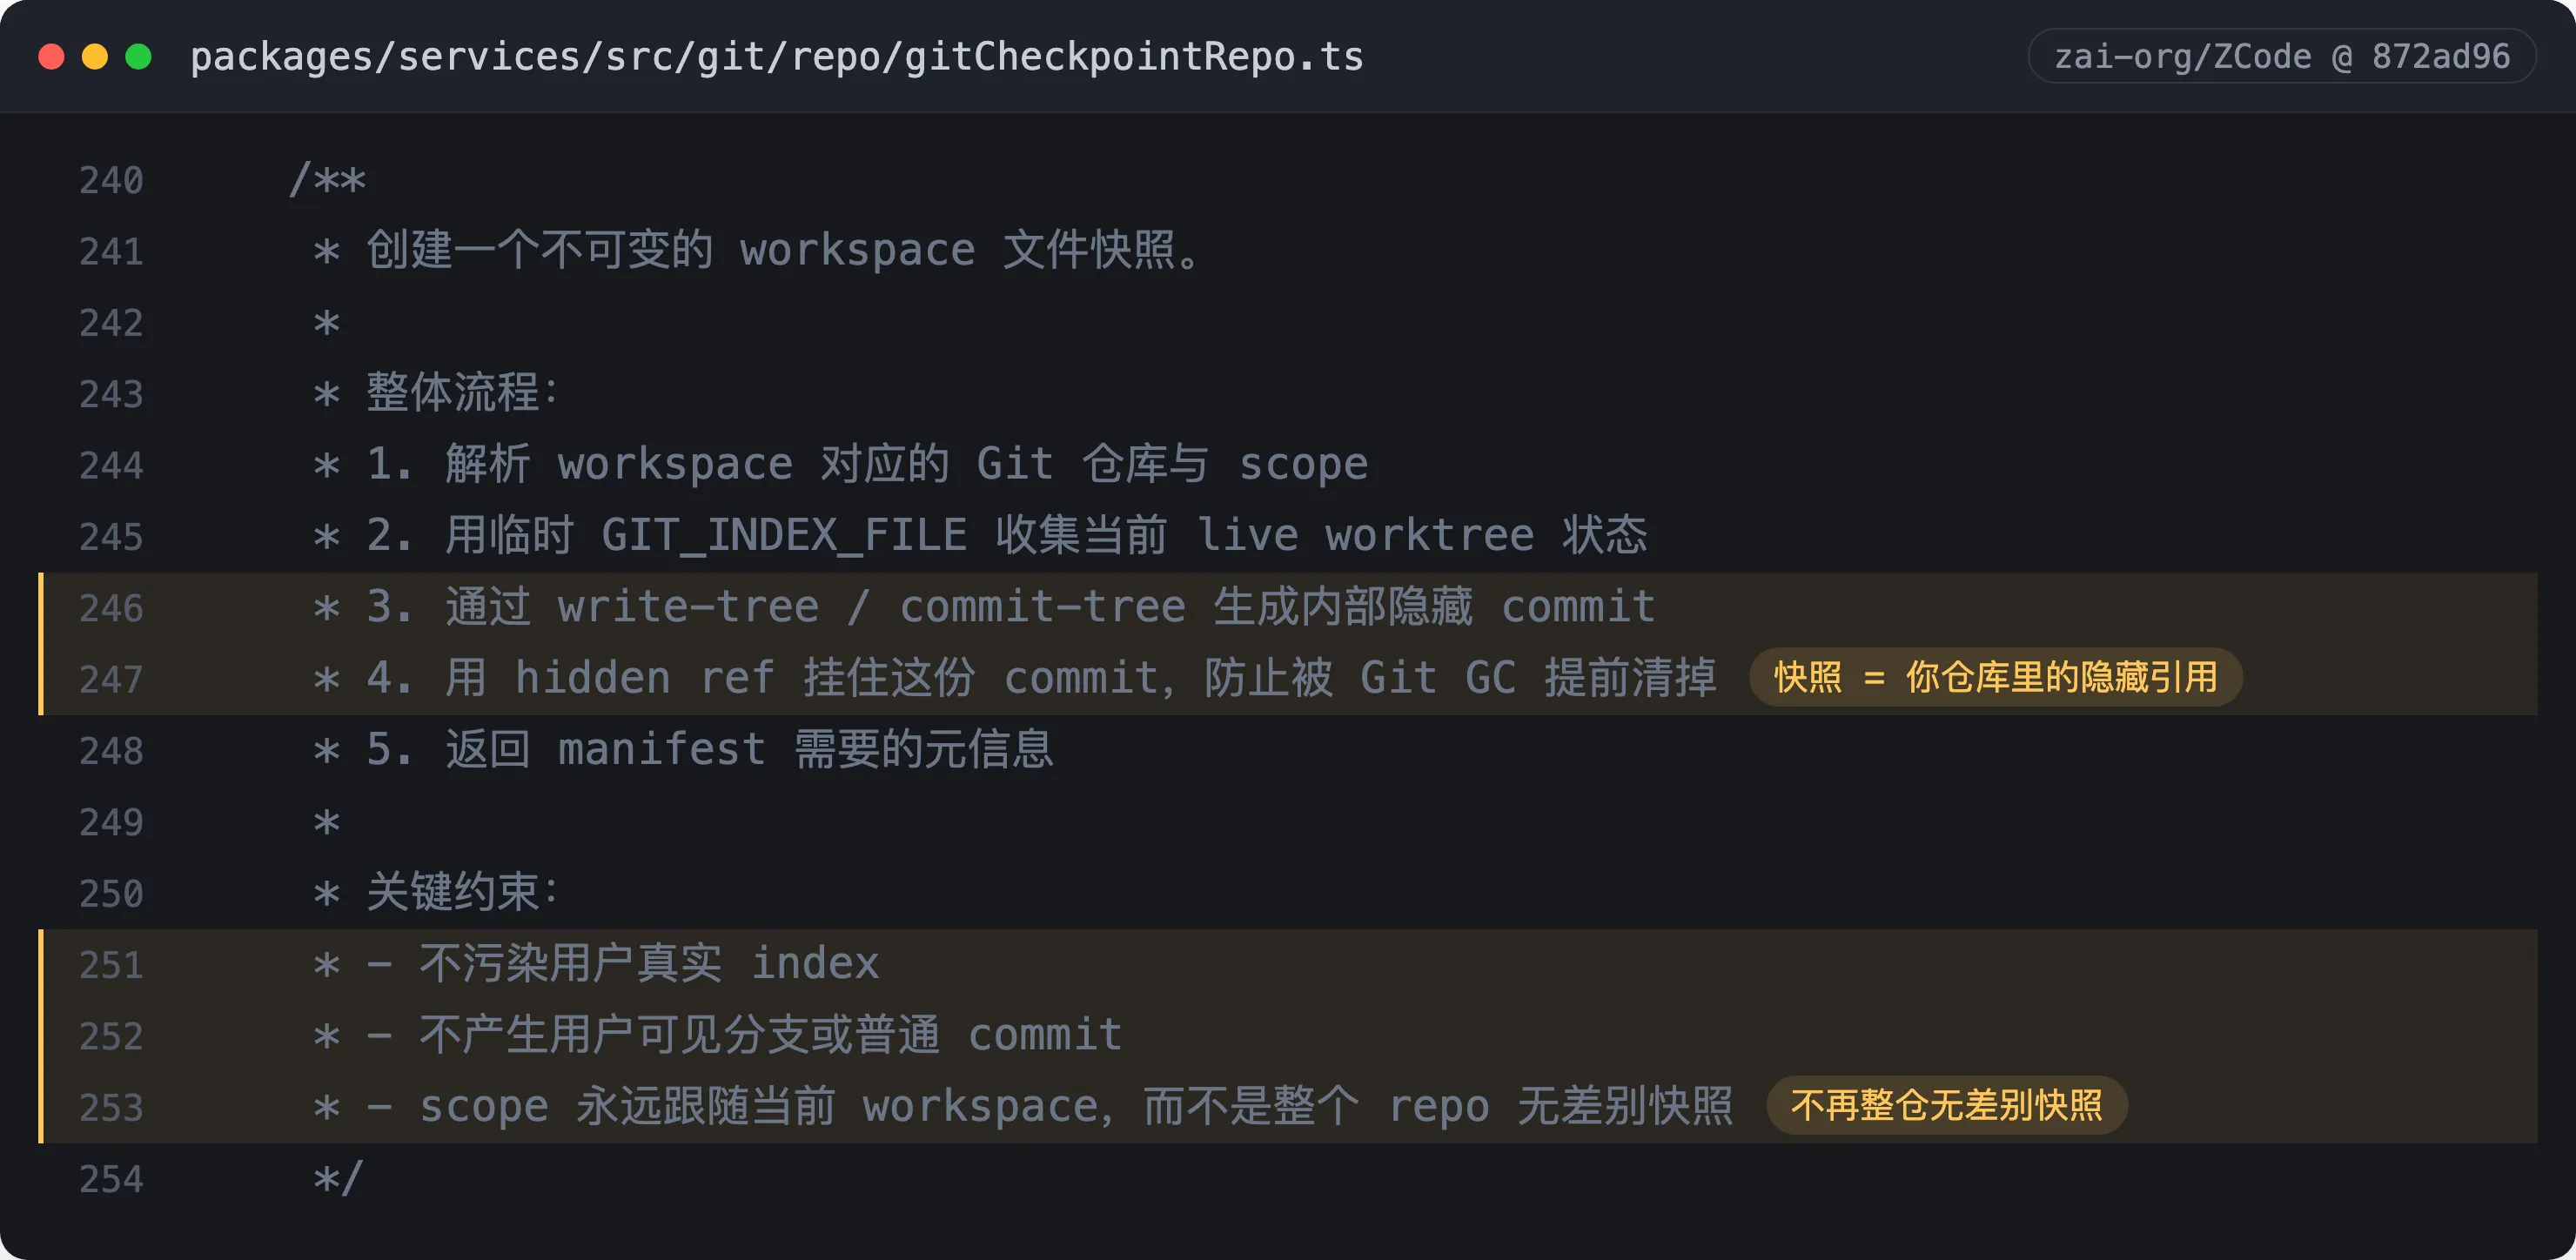
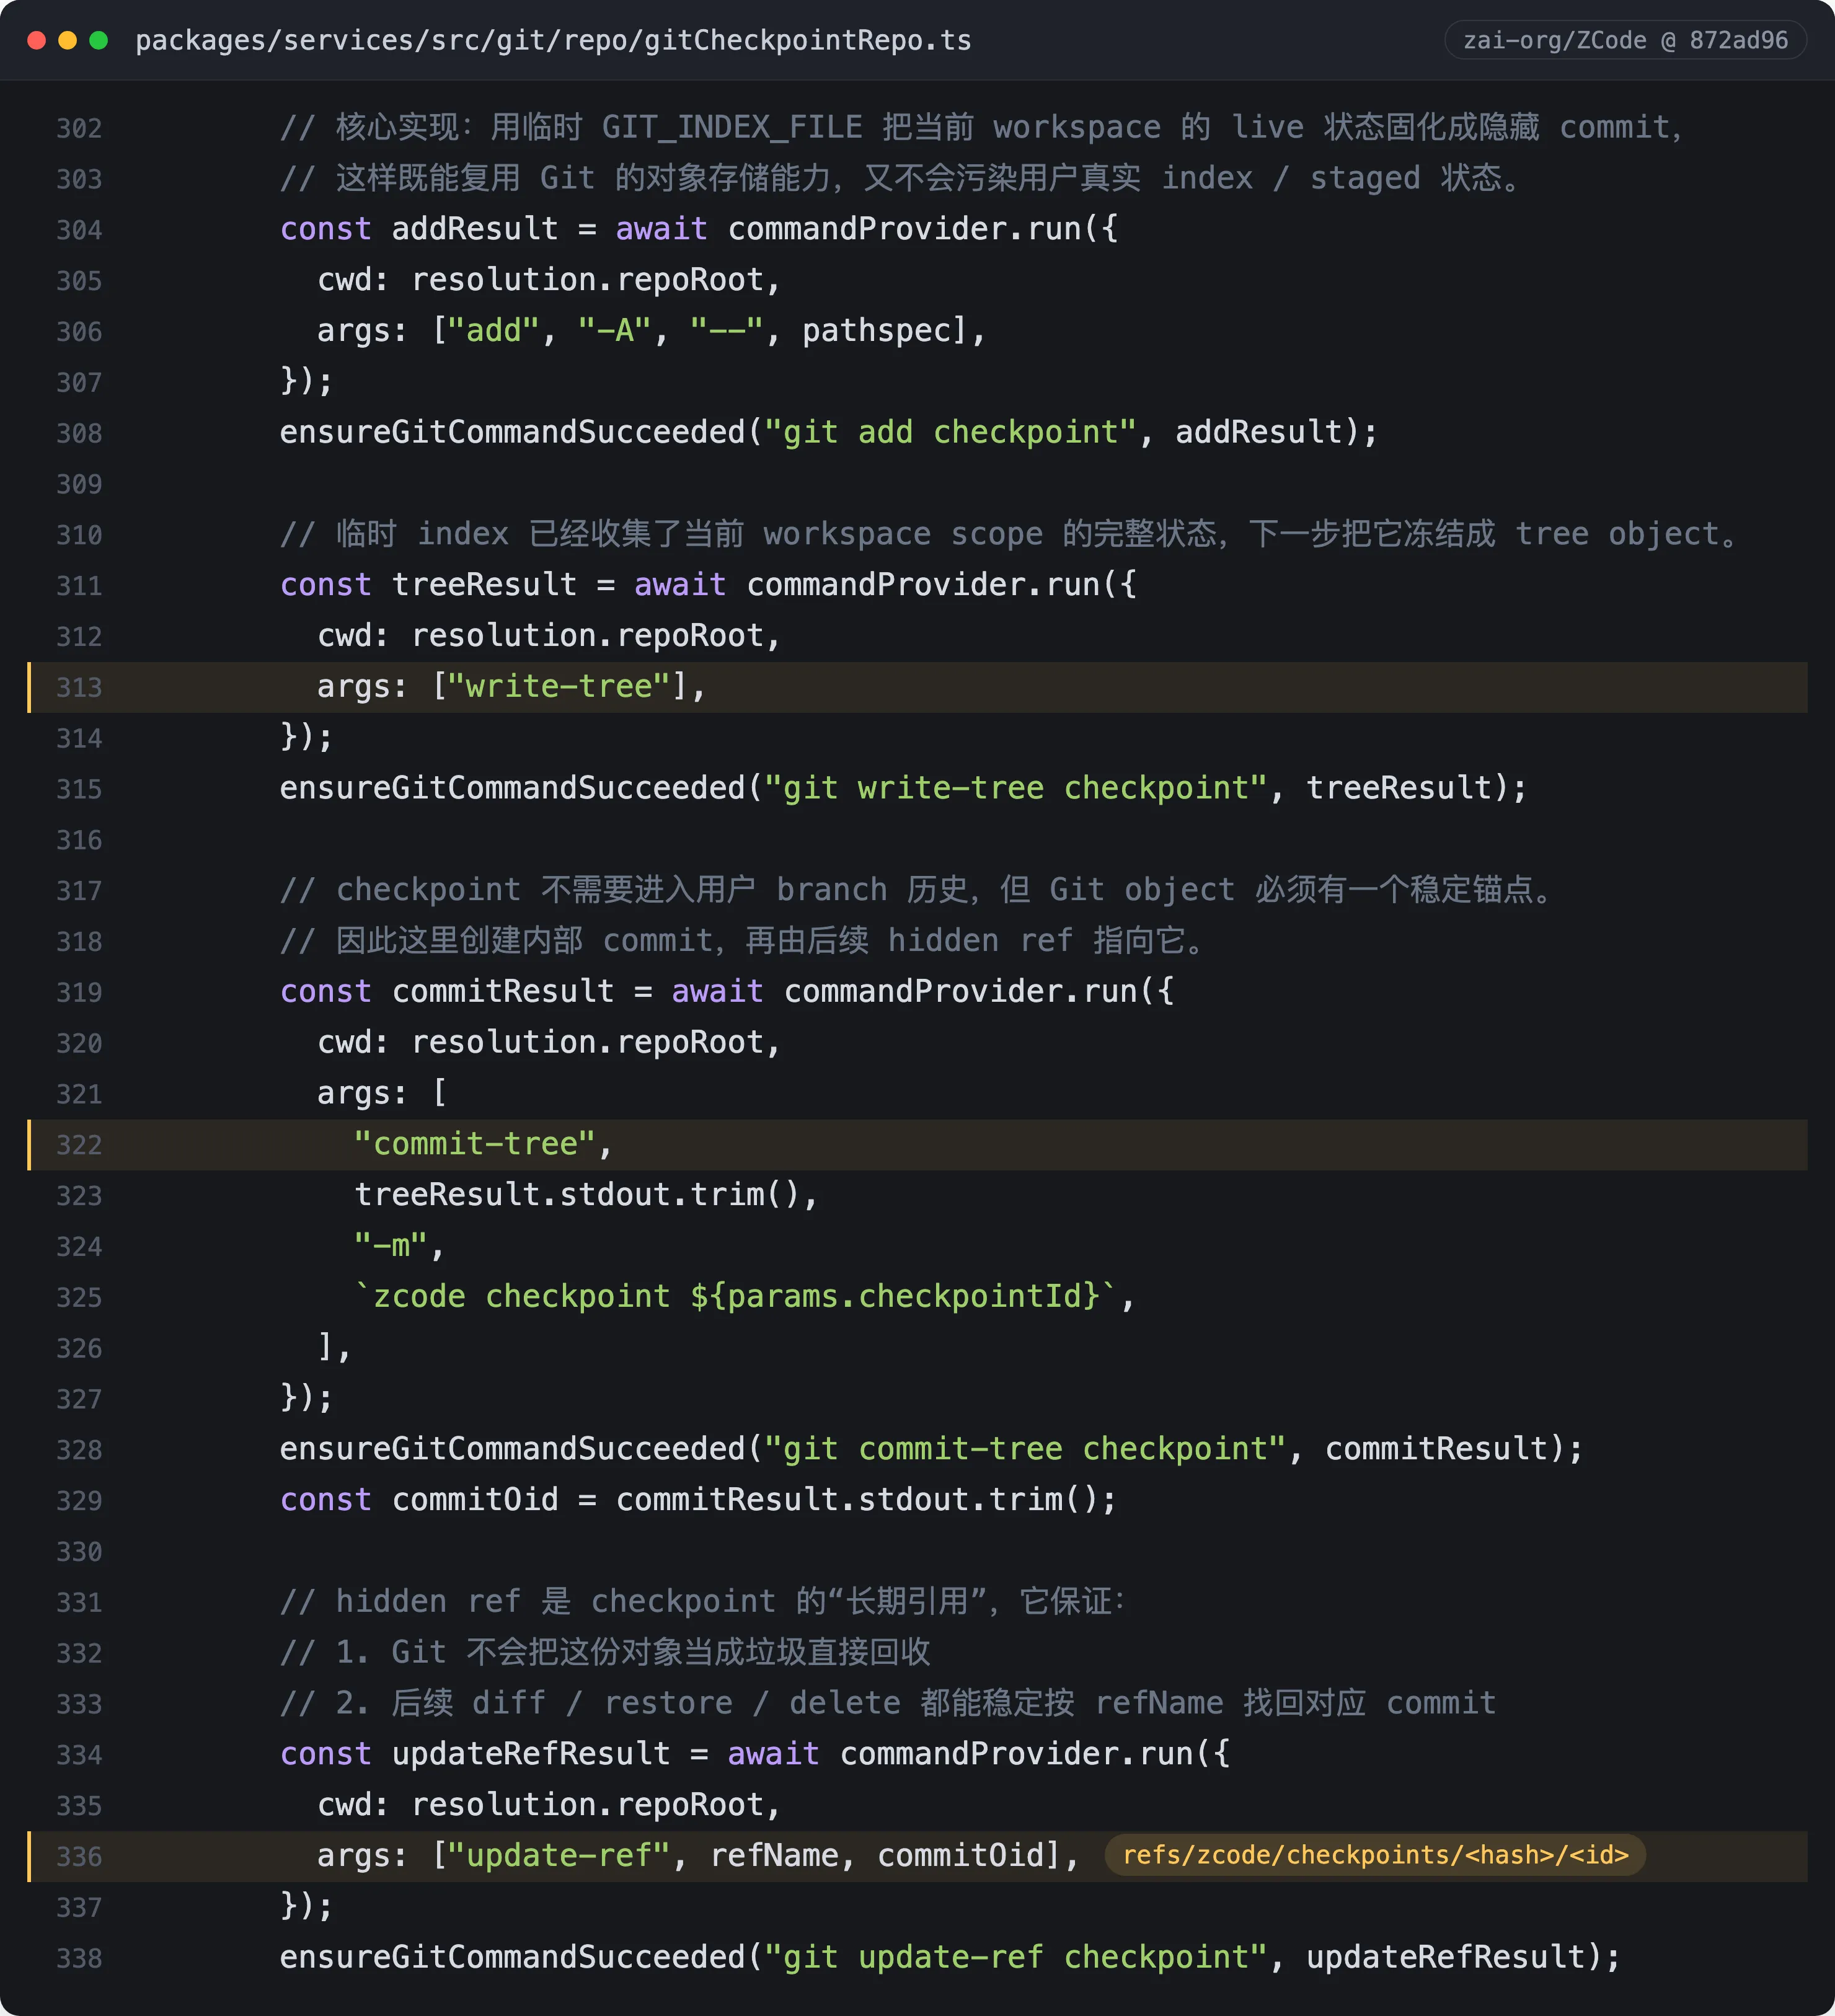
也就是说,官方口径里索引要支撑的那个核心功能(检查点恢复),修复后的形态是纯本地的:零上传、Git 对象自动去重、离线可用、不需要任何密钥。对比一下:
| 旧方案 | 新方案 | |
|---|---|---|
| 存储 | 云端 OSS | 你的 .git 目录 |
| 传输 | 全量上传 | 零 |
| 增量 | 每次全量重打 | Git 对象自动去重 |
| 密钥 | 云端独占 | 不需要 |
| 离线可用 | 否 | 是 |
这个对比把最关键的问题摆上了台面:既然检查点恢复根本不需要上传,当时为什么要上传? 合理的答案只剩云端消费的那些功能——而它们和「本地生成索引」的口径,隔着一条没法弥合的缝。
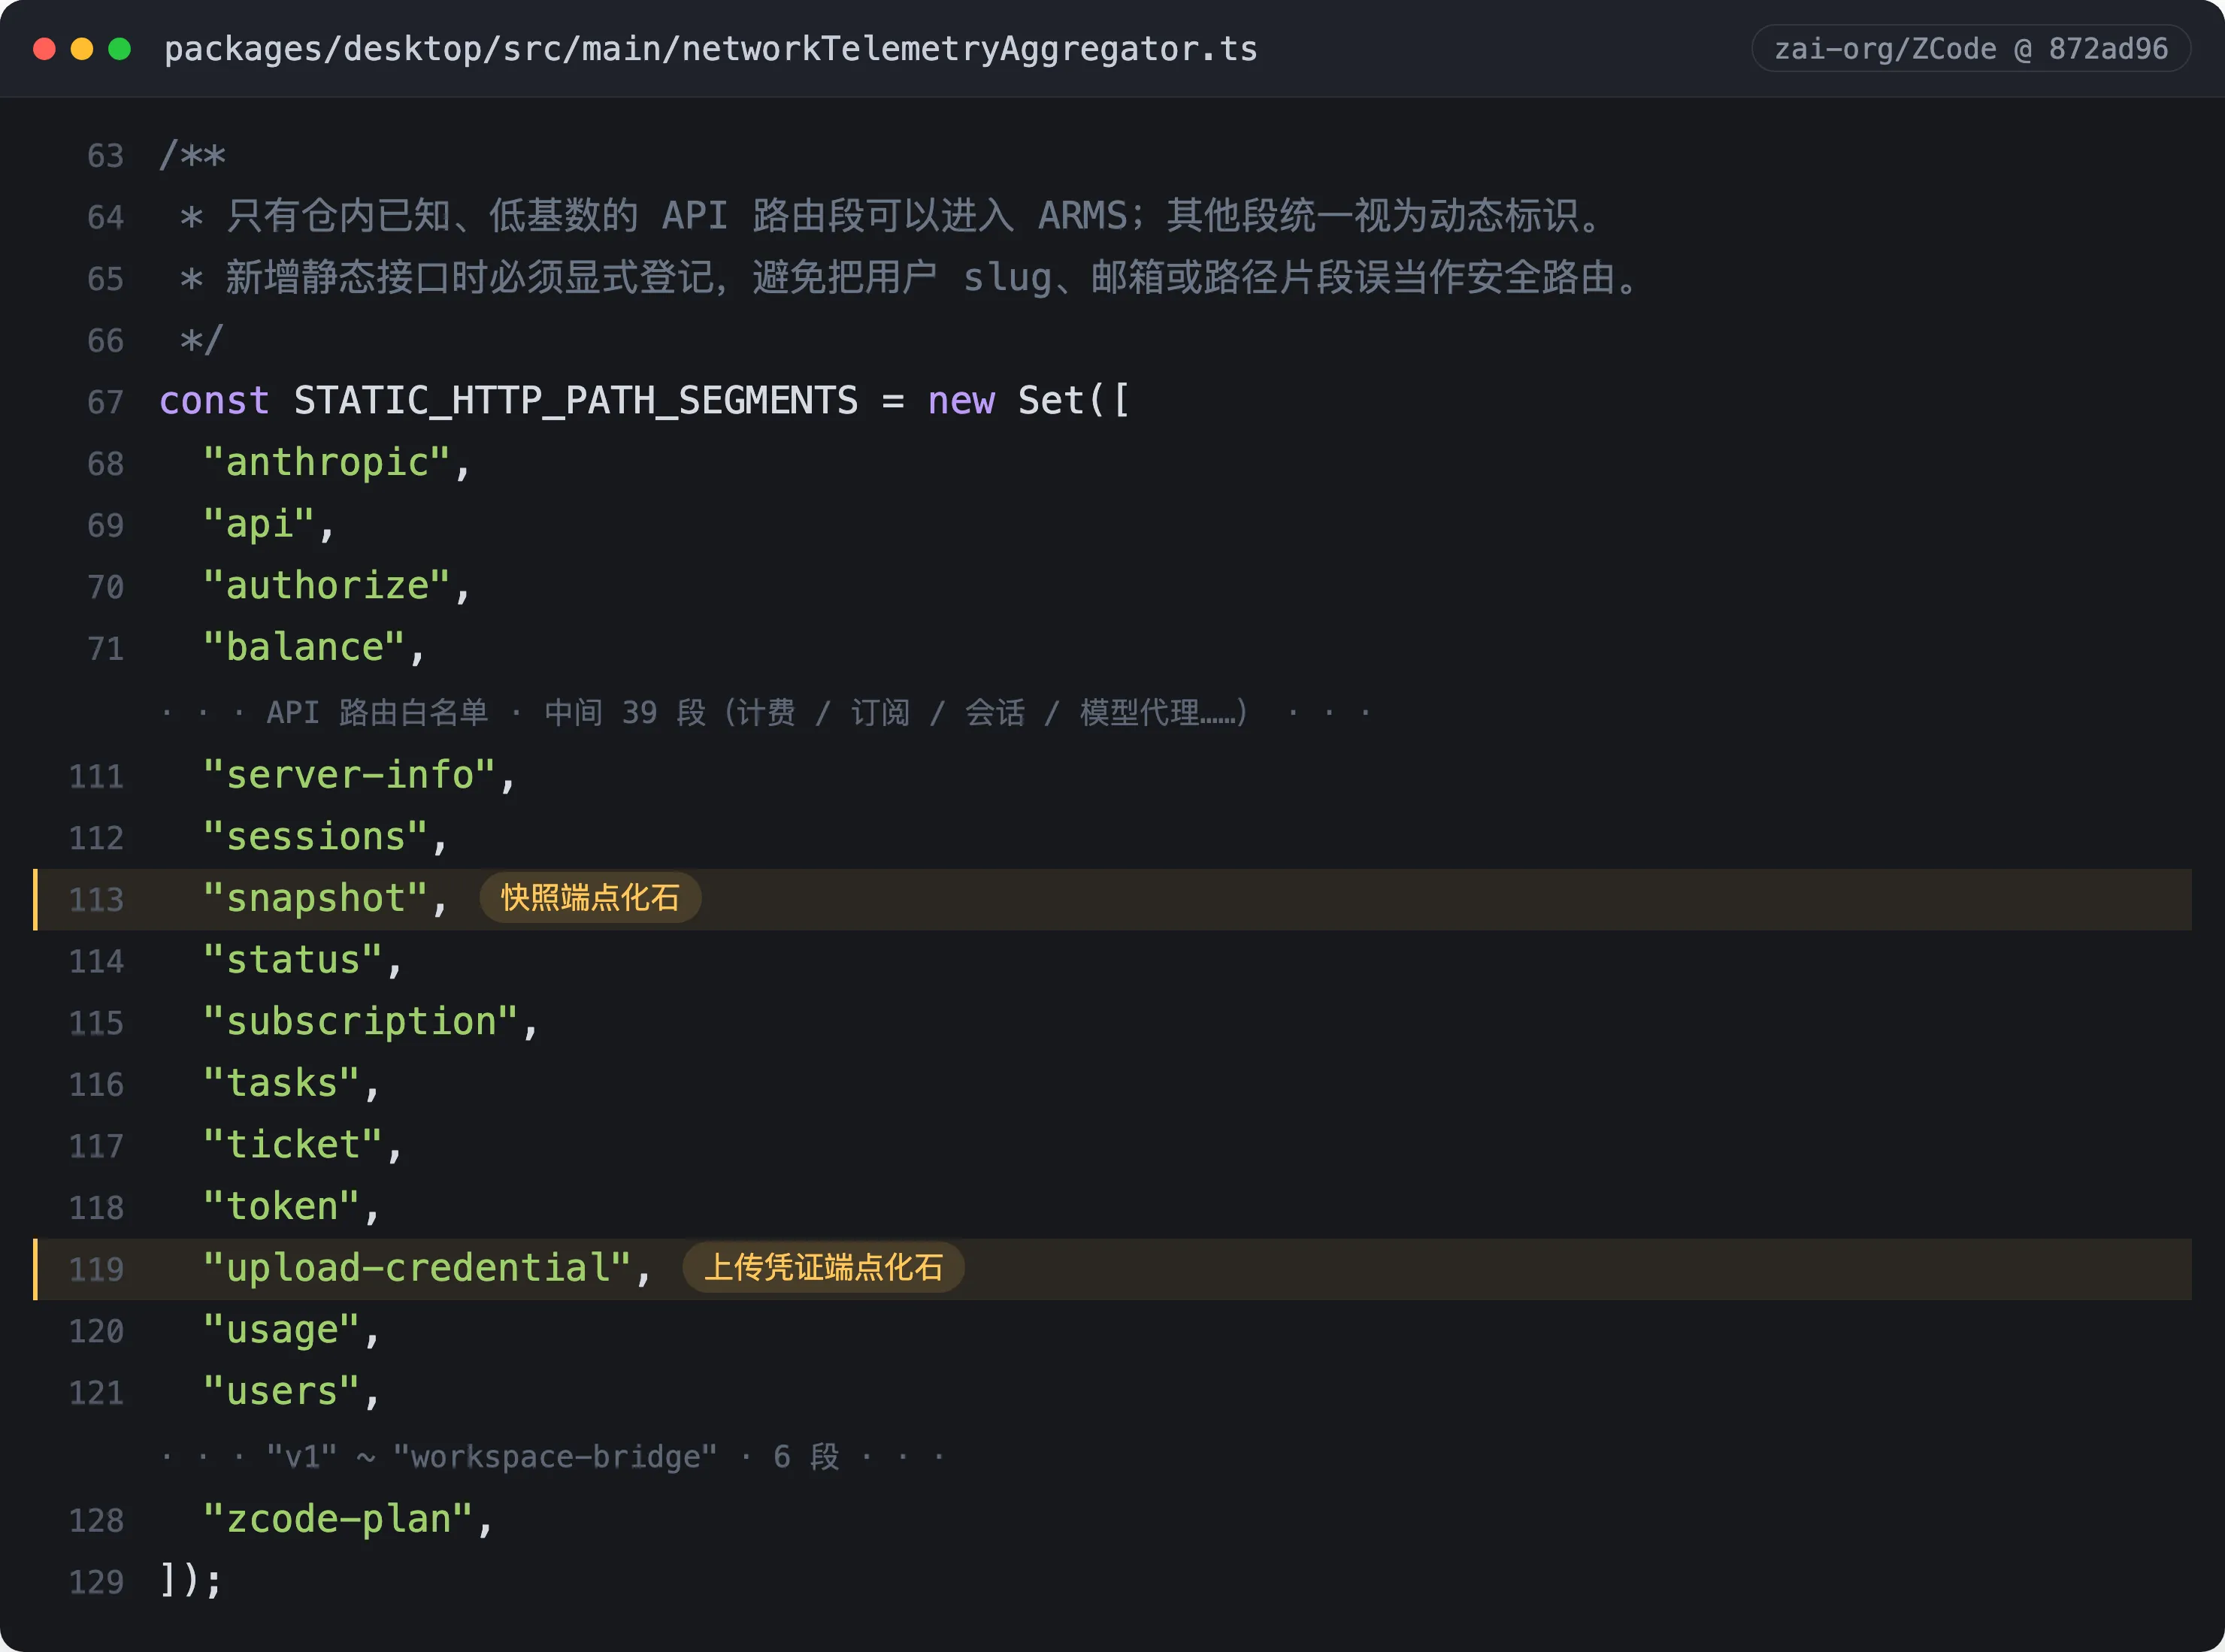
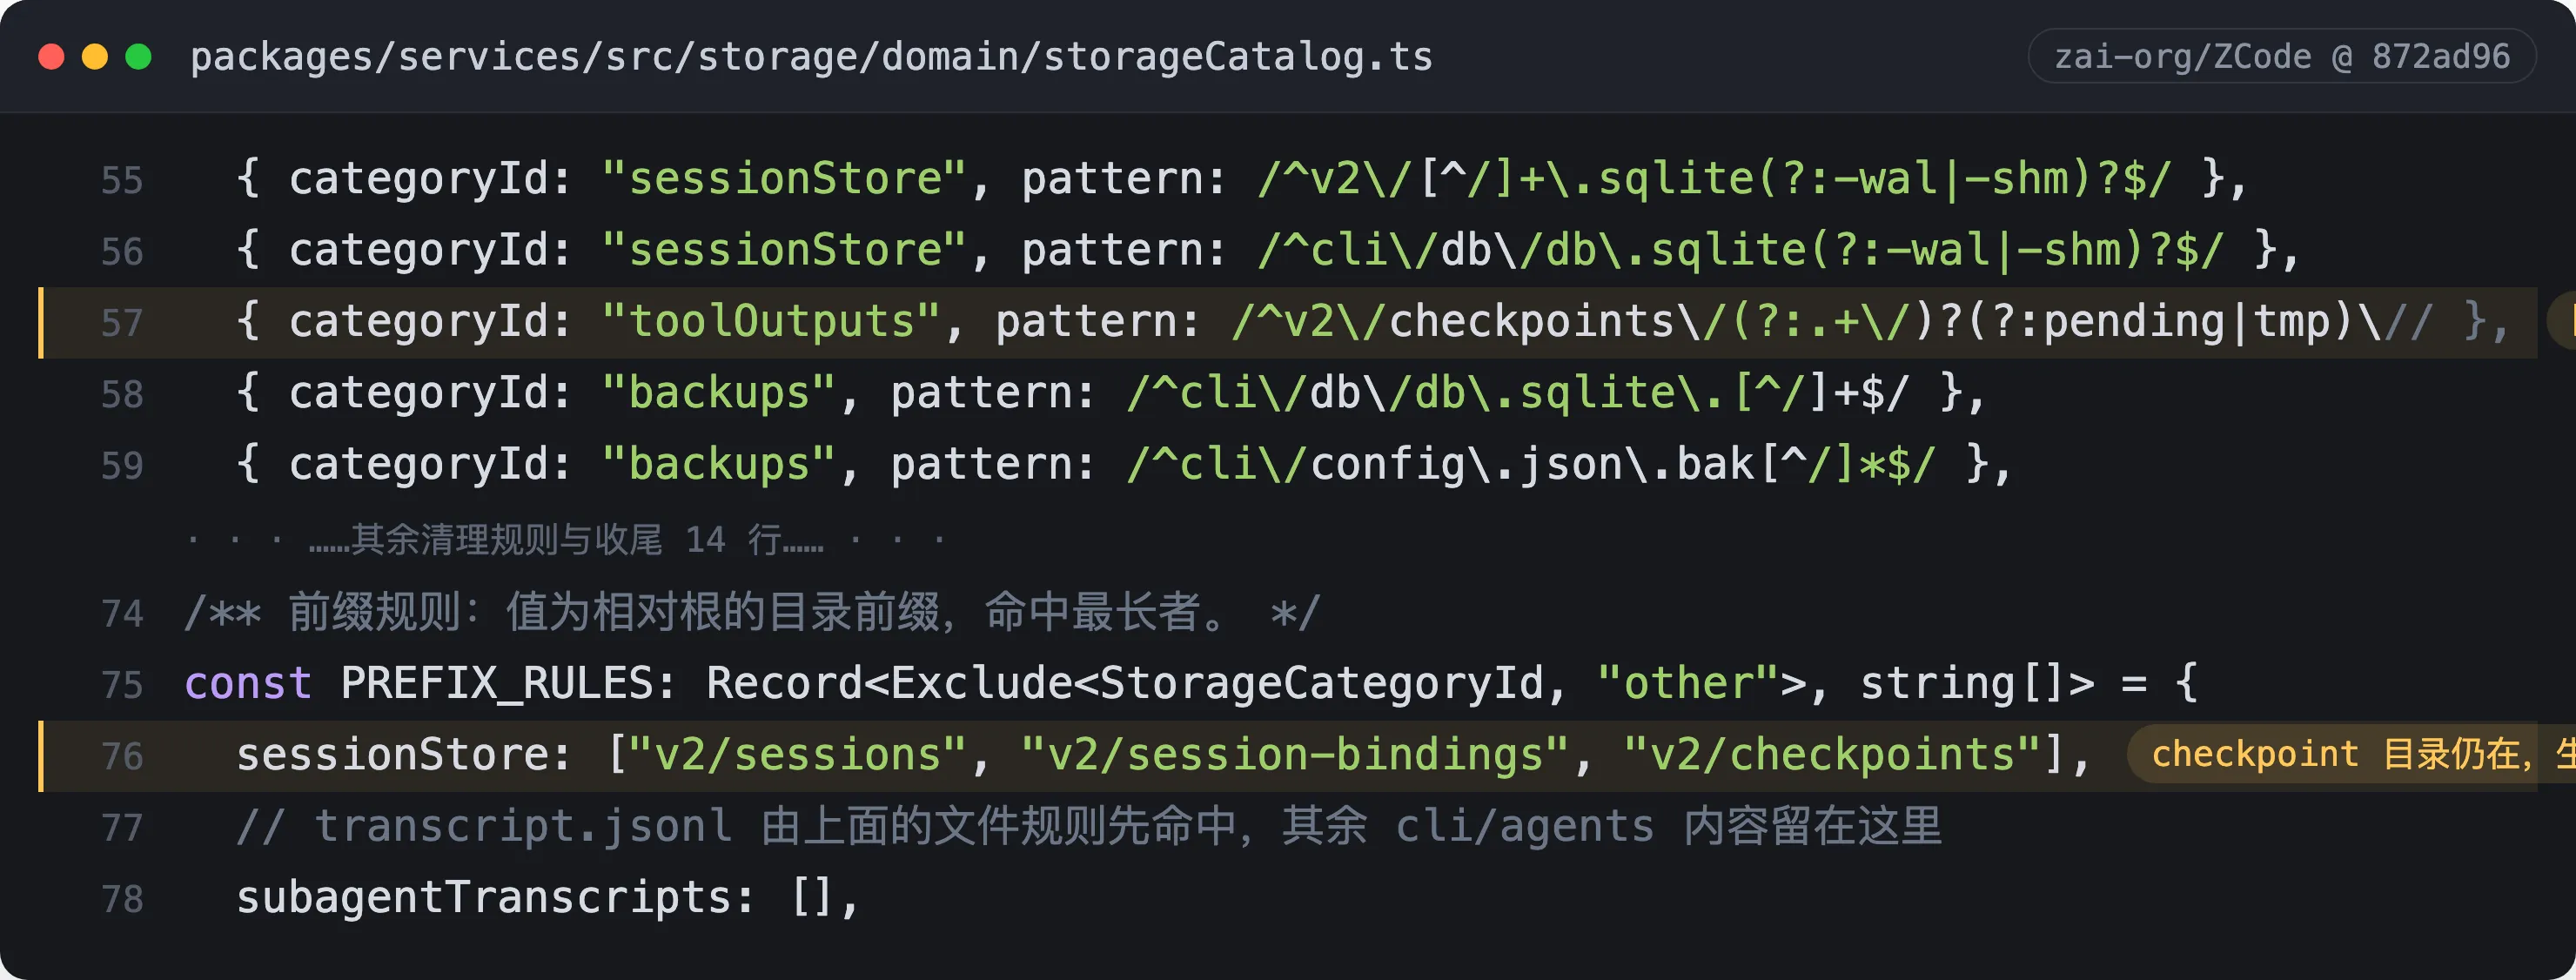
第二,旧方案的化石。网络遥测的路径白名单里还登记着 snapshot 和 upload-credential 两个 API 端点;存储清理模块里还有对旧快照 pending/tmp 目录的清理规则。生成它们的代码删干净了,痕迹没删干净——顺带证实了删除发生在开源之前,开源版本就是整改后的形态。
五、到底会不会存代码
这是所有问题里最直接的一个,答案要拆成三层。
上传时刻:存了。 15KB 小仓库被服务端接受并登记,这是逆向确认的事实。313MB 的商业项目反而因为超限从未成功。
云端处理时刻:以明文形态处理过。 Repo Wiki 生成需要读仓库内容,而私钥在云端——服务端有能力、也有必要把快照解成明文来处理。「生成后立即销毁」说的销毁发生在处理之后。
现在:审计说没了。 信通院确认云端存储桶「零数据」,绿盟确认全部数据对象及桶本身已删除,两家都确认 v3.14.0 已切断快照生成与上传链路——最后这条我在开源代码里独立核对过,属实。
那「会不会存代码」的完整回答就是:上传过、云端解密处理过、现在桶是空的。而审计覆盖不了的部分——快照在云端存续的那段时间里被谁访问过、处理管线里有没有留副本、「无留存、未用于训练」的承诺有没有配套的技术执行——这些既不在审计结论里,也没有任何技术手段可以事后验证。公告里可信的部分(桶已清空、链路已切断)和只能当作承诺的部分(无留存、未训练),值得分开记。
还有一个口径细节值得记录:官方对引发原因的说法,从最初回应的「代码库索引功能默认开启」,到开源公告的「Repo Wiki 功能」,越来越具体、越来越小。而按逆向事实,快照捕获发生在每次提示词之前,Wiki 只是上传的触发时机之一。整条链路删掉了,但「这个行为当初为什么这么设计」——每次对话前全量上传、含全部历史、无开关——官方始终没有正面回答。
六、留给普通开发者的三件事
事件本身会过去,ZCode 的处理(道歉速度、删除动作、开源、第三方审计、赏金计划)在同类事件里算得上体面。但有三件事值得留下来。
第一,给敏感仓库上一把物理锁。 macOS 上 chflags uchg ~/.zcode/v2/checkpoints,Linux 上 sudo chattr +i 对应目录,内核级锁死目录写入。代价是本地检查点功能失效,正常对话、补全、写代码不受影响。
第二,抓一次包,胜过读十篇测评。 给 AI 工具做安全评估不需要逆向能力:装个代理(Proxyman、mitmproxy),看它和谁保持长连接、传了什么体量的数据、什么时机传。ferstar 就是用路由器的连接跟踪,确认那 313MB 从未离开过内网的。数据出境走不走应用服务器,一抓便知——直连对象存储的那种,应用层日志里根本不会有记录。
第三,评估一个工具的数据面,问三个问题。 数据走哪条通道出去(应用接口还是直连存储)?上传的是全部,还是最小必需?关掉开关之后流量真的停了吗?这三个问题的答案,比任何隐私政策的措辞都诚实。
回到最初的问题:为什么上传你的代码?官方给的理由是「索引」,但代码和证据说明,那次上传服务的不是索引——真正的索引能力,修复后根本不需要云。对普通人来说,比「它加密了吗」更值得问的问题顺序是:为什么上传?上传去做什么?存不存?存多久?——这次的答案里,只有一部分经得起核查。
本文涉及的代码事实均来自 zai-org/ZCode 开源仓库(commit 872ad96,单次提交,无历史)与 ferstar 的逆向分析原文,两者可交叉验证的部分已标注;官方口径引自 9 月 18 日情况说明与 9 月 21 日开源公告的公开报道;服务端行为部分为基于公开信息的推断,已在上文明确区分。